
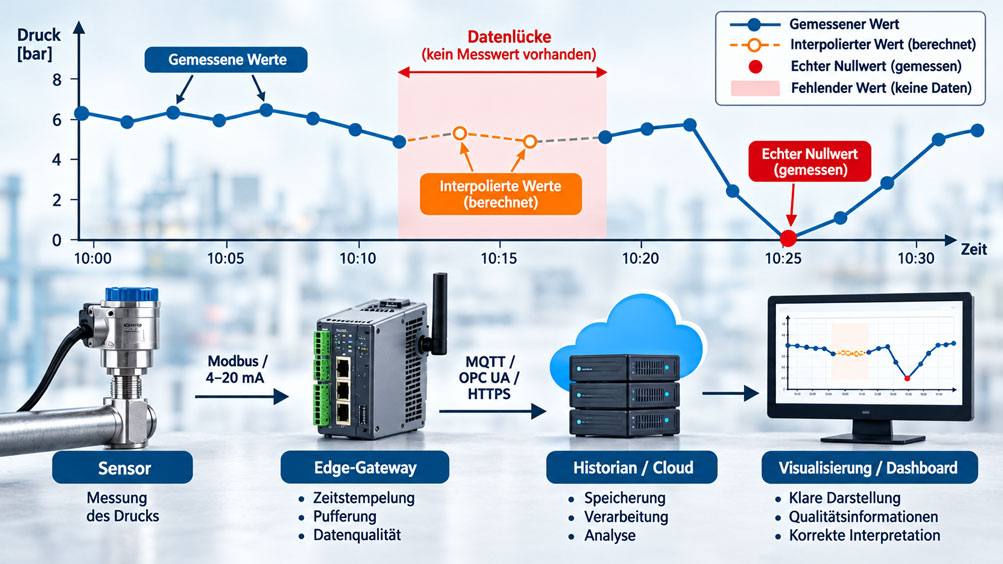
Ein Drucksensor liefert jede Minute einen Messwert an ein Edge-Gateway. Im Historian sieht die Zeitreihe zunächst sauber aus: 6,21 bar, 6,18 bar, 6,24 bar. Dann fehlen für drei Minuten Daten. Anschließend setzt die Aufzeichnung mit 6,27 bar fort.
Was soll nun in den drei fehlenden Minuten gespeichert werden?
Auf den ersten Blick wirken die Möglichkeiten ähnlich. Man könnte 0 eintragen. Man könnte den letzten bekannten Wert weiterführen. Man könnte zwischen 6,24 und 6,27 bar interpolieren. Oder man lässt die Stellen einfach leer.
Für die spätere Auswertung sind diese Varianten jedoch vollkommen unterschiedlich.
Ein Wert von 0 bar ist ein Messwert. Er kann beispielsweise bedeuten, dass eine Anlage drucklos war. Ein fehlender Messwert bedeutet dagegen, dass für den betreffenden Zeitpunkt keine belastbare Messinformation vorhanden ist. Ein interpolierter Wert wiederum ist eine rechnerische Schätzung zwischen bekannten Datenpunkten. Er kann für einen Trend hilfreich sein, ist aber kein tatsächlich gemessener Rohwert.
Wer diese Zustände in der Datenbank gleich behandelt, verändert unbemerkt die Bedeutung der Zeitreihe. Durchschnittswerte werden verfälscht, Maschinenstillstände scheinen aufzutreten, obwohl lediglich die Kommunikation ausgefallen war, und aus berechneten Ersatzwerten können später vermeintliche Originalmessungen werden.
Gerade in IIoT-Architekturen entsteht das Problem nicht ausschließlich in der Datenbank. Eine Messung durchläuft häufig mehrere Ebenen: Sensor, SPS oder Feldbus, Edge-Gateway, lokaler Puffer, MQTT- oder OPC-UA-Kommunikation, Broker, Historian und schließlich Dashboard oder Analyseplattform. An jeder dieser Stellen kann ein Wert verspätet eintreffen, verworfen, dupliziert oder verändert werden.
Die wichtigste Regel lautet deshalb: Der Zahlenwert allein reicht für eine industrielle Zeitreihe nicht aus. Zu einem belastbaren Datenpunkt gehören mindestens ein eindeutiger Zeitbezug und eine Information darüber, ob der Wert tatsächlich gemessen, ungültig, fehlend, verspätet übertragen oder rechnerisch erzeugt wurde.
Warum eine Datenlücke nicht automatisch ein Nullwert ist
In vielen Datenprojekten beginnt das Problem mit einer scheinbar harmlosen Entscheidung. Ein Dashboard erwartet für jede Minute einen numerischen Wert. Für 10:15 Uhr liegt jedoch kein Datensatz vor. Damit die Kurve keine Lücke zeigt, setzt eine Software automatisch 0 ein.
Aus Sicht der Darstellung ist die Zeitreihe nun vollständig. Aus Sicht der Messtechnik wurde aber eine Information erfunden.
Angenommen, es handelt sich um eine Durchflussmessung. Vor der Datenlücke lagen 48,3 l/min an, nach der Lücke 48,7 l/min. Werden für die drei fehlenden Minuten jeweils 0 l/min gespeichert, dokumentiert das System rückwirkend einen Anlagenstillstand, der möglicherweise nie stattgefunden hat.
Aus diesen falschen Nullwerten kann anschließend ein geringerer Tagesverbrauch berechnet werden. Ein Algorithmus erkennt vielleicht drei Pumpenausfälle. Eine Wartungsauswertung zählt unnötige Stillstandsminuten. Was ursprünglich nur ein Kommunikationsproblem war, wird dadurch zu einem vermeintlichen physikalischen Ereignis.
Umgekehrt ist es ebenso problematisch, echte Nullwerte als „keine Daten“ zu behandeln. Ein Volumenstrom von 0 l/min kann ein vollkommen korrekter und wichtiger Betriebszustand sein. Ein Motorstrom von 0 A kann zeigen, dass ein Antrieb tatsächlich ausgeschaltet war. Ein Differenzdruck von 0 Pa kann ein technisch relevantes Ergebnis sein.
Die Semantik muss daher eindeutig bleiben:
0 ≠ kein Messwert
und ebenso:
kein Messwert ≠ 0
Diese Unterscheidung wirkt trivial, entscheidet aber darüber, ob eine Zeitreihe später noch belastbar ausgewertet werden kann.
Wann liegt überhaupt eine echte Lücke vor?
Bevor fehlende Daten behandelt werden, muss zunächst definiert sein, wann ein Messwert erwartet wird. Ohne eine solche Erwartung kann häufig gar nicht entschieden werden, ob eine Zeitreihe eine Lücke besitzt.
Bei einem zyklisch arbeitenden Datenlogger ist die Situation relativ eindeutig. Soll jede Minute ein Temperaturwert gespeichert werden, werden innerhalb einer Stunde normalerweise 60 Datensätze erwartet. Fehlen zwischen 14:12 Uhr und 14:15 Uhr drei Zeitpunkte, liegt eine erkennbare Lücke vor.
Bei ereignisgesteuerten Systemen ist das anders. Ein Sensor kann beispielsweise nur dann einen Wert senden, wenn sich die Temperatur um mindestens 0,5 K verändert. Bleibt sie zwei Stunden konstant, entstehen absichtlich keine neuen Datensätze. Die lange Zeitspanne zwischen zwei Telegrammen ist dann kein Kommunikationsfehler.
Auch digitale Zustände werden häufig nur bei einer Zustandsänderung gespeichert. Wird um 08:00 Uhr „Pumpe EIN“ gemeldet und erst um 11:30 Uhr „Pumpe AUS“, kann die Semantik lauten, dass der Zustand zwischen diesen Ereignissen kontinuierlich „EIN“ war. Eine Datenbank, die zwischen beiden Ereignissen jede Minute einen fehlenden Wert erzeugt, würde das Datenmodell falsch interpretieren.
Deshalb muss zu jeder Messgröße bekannt sein, ob sie zyklisch, ereignisgesteuert oder nach einem Change-of-Value-Verfahren übertragen wird.
Erst mit dieser Information lässt sich festlegen, wann ein Datensatz verspätet und wann er tatsächlich fehlend ist.
Messwert, NULL, ungültig und interpoliert sauber unterscheiden
Ein industrielles Datenmodell sollte mehr Zustände kennen als nur „Zahl vorhanden“ und „Zahl nicht vorhanden“.
Ein gültiger Messwert stammt aus einer realen Erfassung und besitzt einen plausiblen Qualitätsstatus. Dazu gehört selbstverständlich auch der Zahlenwert 0.
Ein fehlender Messwert bedeutet, dass für den erwarteten Zeitpunkt kein verwertbarer Datensatz vorhanden ist. In einer Datenbank kann dies beispielsweise als NULL beziehungsweise durch das vollständige Fehlen des Datensatzes dargestellt werden. Welche Variante besser geeignet ist, hängt vom verwendeten Zeitreihensystem ab.
Davon zu unterscheiden ist ein ungültiger Messwert. Hier hat möglicherweise tatsächlich eine Erfassung stattgefunden, die Datenquelle meldete jedoch einen Fehler. Ein 4–20-mA-Eingang könnte beispielsweise Drahtbruch erkennen, ein Feldgerät einen Bad-Quality-Status liefern oder ein Sensor einen internen Diagnosefehler melden. Dies ist fachlich etwas anderes als ein Kommunikationspaket, das überhaupt nie eingetroffen ist.
Ein interpolierter Wert wird schließlich aus anderen Datenpunkten berechnet. Er kann mathematisch sehr plausibel sein, besitzt aber eine andere Herkunft als eine reale Sensorablesung.
| Zustand | Beispiel | Bedeutung |
|---|---|---|
| Gemessen / Good | 5,32 bar | Sensor hat einen gültigen Messwert geliefert |
| Echter Nullwert | 0,00 bar | Gültige Messung mit dem Zahlenwert 0 |
| Fehlend | NULL / kein Datensatz | Für diesen Zeitpunkt steht kein Messwert zur Verfügung |
| Ungültig | Wert vorhanden, Quality = Bad | Erfassung erfolgte, Wert ist jedoch nicht vertrauenswürdig |
| Interpoliert | 5,34 bar, Quality = Estimated | Wert wurde rechnerisch aus benachbarten Datenpunkten erzeugt |
| Stale / veraltet | 5,32 bar, aber keine Aktualisierung | Letzter bekannter Wert wird angezeigt, obwohl keine neue Messung vorliegt |
Diese Zustände sollten nicht nachträglich aus dem Zahlenwert erraten werden müssen. Sie gehören möglichst explizit in das Datenmodell.
Warum echte Nullwerte erhalten bleiben müssen
Der Zahlenwert 0 besitzt in industriellen Daten eine fachliche Bedeutung und darf deshalb nicht als Ersatzcode für „nicht vorhanden“ missbraucht werden.
Bei einem Durchflussmesser kann 0 bedeuten, dass das Medium tatsächlich steht. Bei einem Stromsensor kann 0 A bedeuten, dass der Verbraucher abgeschaltet wurde. Eine Waage kann nach einer Tarierung genau 0 kg anzeigen. Ein Positionssensor kann seinen definierten Nullpunkt erreicht haben.
Wer Nullwerte bei der Datenbereinigung entfernt, weil sie vermeintlich „unrealistisch“ aussehen, kann reale Maschinenzustände verlieren.
Das gilt auch für statistische Berechnungen. Angenommen, eine Maschine liefert während fünf Minuten die Durchflusswerte:
10 / 10 / 0 / 10 / 10 l/min
Der Mittelwert beträgt korrekt 8 l/min. Wird der Nullwert als fehlend verworfen, ergibt die Berechnung 10 l/min und bildet den tatsächlichen Prozess nicht mehr ab.
Umgekehrt wäre ein Datensatz:
10 / 10 / NULL / 10 / 10 l/min
fachlich vollkommen anders zu bewerten. Hier ist unbekannt, welcher Wert während der dritten Minute tatsächlich vorlag.
Eine Datenanalyse sollte diesen Unterschied erkennen können, ohne auf Annahmen zurückgreifen zu müssen.
Qualitätsstatus statt Sonderzahlen verwenden
Historisch wurden ungültige Messwerte manchmal durch besondere Zahlen gekennzeichnet. Ein Sensorwert von −9999 oder 99999 bedeutete dann beispielsweise „Kommunikationsfehler“.
Solche Verfahren sind für moderne IIoT-Datenmodelle problematisch. Eine Anwendung muss wissen, dass −9999 kein tatsächlicher Messwert ist. Wird diese Sonderregel bei einer späteren Datenintegration vergessen, gelangt der Fehlerwert in Diagramme, Mittelwerte oder Machine-Learning-Modelle.
Robuster ist die Trennung zwischen Zahlenwert und Datenqualität.
Ein Datenpunkt kann beispielsweise einen Wert von 23,7 °C enthalten und gleichzeitig die Qualität „Good“ besitzen. Bei einem Sensorfehler kann der letzte Rohwert technisch noch vorhanden sein, während der Qualitätsstatus „Bad“ signalisiert, dass dieser Wert nicht verwendet werden sollte.
Auch ein interpolierter Wert sollte eine eigene Qualitätskennzeichnung erhalten. Dadurch kann ein Dashboard ihn bei Bedarf darstellen, während eine Qualitätsauswertung ausschließlich echte Messwerte berücksichtigt.
Die genaue Benennung der Statuswerte hängt vom verwendeten System ab. Entscheidend ist weniger, ob der Zustand „Estimated“, „Interpolated“, „Uncertain“ oder anders heißt. Wichtig ist, dass seine Bedeutung eindeutig dokumentiert und über alle Ebenen der Datenkette erhalten bleibt.
Zeitstempel entscheidet über die richtige Zuordnung
Eine Datenlücke lässt sich nur dann richtig beurteilen, wenn klar ist, auf welchen Zeitpunkt sich ein Messwert bezieht.
Ein Sensor kann beispielsweise um 10:15:00 Uhr einen Wert erfassen. Aufgrund einer Netzwerkstörung erreicht dieser Datensatz das Edge-Gateway jedoch erst um 10:18 Uhr und die Cloud um 10:20 Uhr.
Wird ausschließlich die Cloud-Empfangszeit gespeichert, scheint der Wert um 10:20 Uhr entstanden zu sein. In der Zeitreihe bleibt für 10:15 Uhr eine vermeintliche Lücke zurück.
Wird dagegen der ursprüngliche Erfassungszeitpunkt erhalten, kann der verspätet eintreffende Datensatz später korrekt an 10:15 Uhr eingeordnet werden.
Für industrielle Messdaten ist es deshalb sinnvoll, zwischen dem eigentlichen Erfassungs- beziehungsweise Source Timestamp und einer späteren Empfangs- oder Ingestion-Zeit unterscheiden zu können.
Die Empfangszeit ist nicht wertlos. Im Gegenteil: Aus der Differenz zwischen Messzeit und Empfangszeit lassen sich Kommunikationsverzögerungen erkennen. Sie sollte aber den ursprünglichen Messzeitpunkt nicht ersetzen.
Besonders wichtig wird dies bei Edge-Pufferung. Werden Daten während eines Netzwerkausfalls lokal gespeichert und Stunden später übertragen, müssen die ursprünglichen Zeitstempel erhalten bleiben. Sonst wird aus einer sauber gepufferten Messhistorie beim späteren Upload eine zeitlich falsche Datenwolke.
Kommunikationsausfall ist nicht automatisch Messausfall
Eine Unterbrechung der Verbindung zwischen Edge-Gateway und Cloud bedeutet nicht zwangsläufig, dass auch die Messung ausgefallen ist.
Angenommen, ein Gateway erfasst weiterhin jede Sekunde Druckwerte, verliert aber für 20 Minuten die Verbindung zum MQTT-Broker. Besitzt das System einen persistenten lokalen Puffer, können diese 1.200 Messwerte weiterhin mit ihren ursprünglichen Zeitstempeln gespeichert werden.
Nach Wiederherstellung der Verbindung werden sie nachträglich übertragen. Im endgültigen Historian kann dadurch eine lückenlose Zeitreihe entstehen, obwohl die Online-Darstellung während der Störung 20 Minuten lang keine neuen Werte erhalten hat.
Damit müssen zwei unterschiedliche Qualitätsfragen getrennt werden:
Die erste lautet: Hat die Messwerterfassung funktioniert?
Die zweite lautet: Hat die Übertragung zum übergeordneten System funktioniert?
Eine Architektur, die diese beiden Zustände vermischt, kann im Nachhinein häufig nicht mehr feststellen, ob eine Lücke im Sensor, am Feldbus, am Gateway oder erst beim Cloud-Transport entstanden ist.
Lokale Pufferung ist deshalb nicht nur ein Verfügbarkeitsmerkmal. Sie hilft, die ursprüngliche Messhistorie auch bei temporären Kommunikationsstörungen zu erhalten.
Verspätete Werte korrekt nachtragen
Store-and-Forward-Systeme führen zu einer weiteren Anforderung: Daten können außerhalb ihrer zeitlichen Reihenfolge eintreffen.
Der Historian erhält beispielsweise zuerst den aktuellen Wert von 10:30 Uhr und anschließend aus einem wiederhergestellten Puffer Werte von 10:10 bis 10:20 Uhr.
Ein robustes System muss diese Datensätze anhand ihres Messzeitpunktes in die Historie einordnen können. Gleichzeitig sollte verhindert werden, dass ein Wiederholungsversuch denselben Messwert mehrfach speichert.
Für diese Aufgabe sind neben dem Zeitstempel eindeutige Datenpunkt- beziehungsweise Nachrichtenidentitäten, Sequenznummern oder geeignete Deduplizierungsregeln hilfreich.
Die genaue technische Umsetzung hängt von Gateway, Protokoll und Datenbank ab. Das Datenmodell sollte jedoch grundsätzlich damit rechnen, dass industrielle Messwerte nicht immer in perfekter chronologischer Reihenfolge am Zielsystem eintreffen.
Ein später eintreffender Originalmesswert sollte außerdem einen zuvor nur zu Darstellungszwecken interpolierten Wert nicht einfach unsichtbar überschreiben. Besser ist eine Architektur, in der klar bleibt, welcher Wert gemessen und welcher zuvor nur berechnet wurde.
Change-of-Value: lange Zeit ohne Datensatz kann völlig normal sein
Besonders leicht entstehen Fehlinterpretationen bei Change-of-Value- beziehungsweise Deadband-Verfahren.
Ein Temperatursensor kann beispielsweise so konfiguriert sein, dass er nur dann einen neuen Wert sendet, wenn sich die Temperatur gegenüber dem letzten übertragenen Wert um mindestens 0,2 K verändert.
Bleibt der Prozess über 30 Minuten nahezu konstant, erscheinen während dieser Zeit keine neuen Telegramme.
Eine klassische zyklische Zeitreihe würde daraus 30 fehlende Minuten ableiten. Das wäre jedoch falsch. Das System hat genau entsprechend seiner Übertragungsstrategie gearbeitet.
Damit der Datenempfänger den Unterschied zwischen „kein neuer Wert, weil unverändert“ und „kein neuer Wert, weil Verbindung ausgefallen“ erkennen kann, benötigt die Architektur zusätzliche Informationen. Ein periodischer Heartbeat, Kommunikationsstatus oder definierter Maximalabstand zwischen Statusmeldungen kann dafür verwendet werden.
Auch die grafische Darstellung muss die Datenlogik kennen. Bei einem Zustandswert kann es korrekt sein, den letzten bekannten Wert bis zur nächsten Zustandsänderung weiterzuführen. Bei einem kontinuierlichen Analogwert darf dieselbe Darstellung dagegen bereits eine Interpretation darstellen.
Die Regeln zur Lückenbehandlung müssen deshalb pro Messgröße und Erfassungsstrategie definiert werden – nicht global für die gesamte Datenplattform.
Wann Interpolation sinnvoll sein kann
Interpolation ist nicht grundsätzlich falsch. Sie ist ein nützliches mathematisches Werkzeug, wenn klar ist, wofür der berechnete Wert verwendet wird.
Ein langsam veränderlicher Temperaturprozess besitzt beispielsweise alle zehn Sekunden einen Messwert. Fällt genau ein Wert aus und liegen davor 80,1 °C und danach 80,3 °C an, kann ein linear interpolierter Zwischenwert von 80,2 °C für eine grafische Trenddarstellung durchaus sinnvoll sein.
Die Situation ändert sich bei einem hochdynamischen Signal. Fehlt während eines Motorstarts ein Messwert zwischen 20 A und 25 A, kann der reale Strom dazwischen 200 A betragen haben. Eine lineare Verbindung würde den entscheidenden Einschaltpeak vollständig verstecken.
Dasselbe gilt für Alarme, Grenzwertüberschreitungen, Schaltzustände oder andere ereignisartige Daten. Ein mathematisch glatter Verlauf kann dort gerade das Ereignis beseitigen, das eigentlich untersucht werden soll.
Deshalb sollte eine Interpolation immer mindestens drei Fragen beantworten: Welche Messgröße wird betrachtet? Wie lang ist die Lücke? Und für welchen Zweck wird der Ersatzwert benötigt?
Ein Wert, der für eine übersichtliche Diagrammdarstellung akzeptabel ist, muss deshalb noch lange nicht für eine Qualitätsfreigabe, Bilanzierung oder Sicherheitsentscheidung geeignet sein.
Lineare Interpolation, Forward Fill und andere Verfahren unterscheiden
Die richtige Methode hängt von der physikalischen Bedeutung der Messgröße ab.
Bei einer linearen Interpolation wird zwischen zwei bekannten Punkten ein gleichmäßiger Verlauf angenommen. Das eignet sich am ehesten für kurze Lücken in langsam und kontinuierlich veränderlichen Größen.
Beim sogenannten Forward Fill wird dagegen der letzte bekannte Wert bis zum nächsten Datenpunkt weitergeführt. Für einen diskreten Zustand wie „Ventil geöffnet“ kann dies genau dem Datenmodell entsprechen, wenn nur Zustandsänderungen gespeichert werden. Für einen analogen Prozessdruck wäre dieselbe Methode dagegen eine Annahme, dass sich der Druck während der gesamten Lücke nicht verändert hat.
Zählerstände stellen wiederum eine eigene Datenklasse dar. Fehlt ein Energiezählerstand zwischen 1.000 und 1.020 kWh, bedeutet dies nicht, dass während der Lücke der Zählerwert 0 war. Eine Zwischenwertbildung kann für bestimmte Verbrauchsauswertungen sinnvoll sein, muss aber berücksichtigen, dass der Zähler monoton arbeitet, eventuell zurückgesetzt wurde oder übergelaufen sein kann.
Für industrielle Anwendungen ist deshalb eine einzige globale Funktion „fill missing values“ meist zu grob.
Stattdessen sollte für jede relevante Variable festgelegt werden, ob Interpolation zulässig ist, welche Methode verwendet werden darf und wie groß die maximal zu überbrückende Lücke sein darf.
Interpolierte Werte niemals stillschweigend zu Rohdaten machen
Eine der wichtigsten Architekturentscheidungen betrifft die Trennung zwischen Rohdaten und aufbereiteten Daten.
Angenommen, im Rohdatensatz fehlt um 12:03 Uhr ein Temperaturwert. Eine Analyse erzeugt dafür später 54,7 °C durch lineare Interpolation.
Wird dieser Wert direkt in dieselbe Rohdatentabelle geschrieben und ist anschließend nicht mehr erkennbar, dass er berechnet wurde, ist die ursprüngliche Datenlage verloren.
Ein späterer Benutzer sieht 54,7 °C und geht davon aus, dass der Sensor diesen Wert tatsächlich geliefert hat.
Robuster ist es, die Originaldaten unverändert aufzubewahren und berechnete Werte entweder in einer separaten aufbereiteten Datenebene zu führen oder mindestens mit Herkunft und Qualitätsstatus eindeutig zu markieren.
Damit kann ein Dashboard eine glatte Kurve zeigen, während eine Ursachenanalyse weiterhin erkennt, dass an dieser Stelle keine reale Messung vorlag.
Diese Trennung ist auch für zukünftige Algorithmen wichtig. Wird später eine andere Interpolationsmethode verwendet, können die Ersatzwerte jederzeit neu berechnet werden. Die ursprünglichen Messdaten bleiben unverändert erhalten.
Mittelwerte und Aggregate bei Lücken richtig bewerten
Datenlücken beeinflussen nicht nur einzelne Kurvenpunkte, sondern auch daraus berechnete Kennwerte.
Angenommen, aus sekündlichen Temperaturmessungen soll für jede Minute ein Mittelwert erzeugt werden. Normalerweise stehen dafür 60 Messwerte zur Verfügung.
In einer bestimmten Minute wurden aufgrund einer Kommunikationsstörung jedoch nur 12 Werte erfasst. Rechnerisch lässt sich auch daraus ein Mittelwert bilden. Dieser besitzt aber nicht dieselbe Aussagekraft wie ein Mittelwert aus 60 vollständig verteilten Messpunkten.
Deshalb sollte ein Aggregat nicht nur aus dem Ergebniswert bestehen.
Hilfreich sind zusätzliche Informationen darüber, wie viele Werte erwartet wurden, wie viele tatsächlich verwendet wurden und ob ungültige oder interpolierte Daten enthalten sind.
Ein Minutenmittelwert von 52,4 °C mit 60 von 60 gültigen Messpunkten ist fachlich etwas anderes als 52,4 °C aus 12 von 60 Messpunkten.
Besonders problematisch ist die automatische Ergänzung fehlender Werte mit 0 vor der Mittelwertbildung. Dadurch wird aus mangelnder Datenqualität unmittelbar ein falscher Prozesswert.
Eine gute Verdichtungsstrategie erhält deshalb Informationen über die Vollständigkeit des jeweiligen Zeitfensters.
Warum Datenlücken nicht als sicherer Anlagenzustand gelten dürfen
Bei Alarm- und Überwachungsfunktionen kann eine falsche Lückenbehandlung besonders problematisch werden.
Angenommen, ein Temperaturwert wird überwacht und oberhalb von 90 °C soll ein Alarm entstehen. Der letzte gültige Messwert liegt bei 88 °C. Danach fällt die Kommunikation aus.
Wird der fehlende Wert automatisch als 0 °C interpretiert, scheint der Prozess plötzlich weit vom Alarmbereich entfernt zu sein.
Die sachlich korrekte Aussage lautet aber nicht „Temperatur = 0 °C“, sondern „aktuelle Temperatur unbekannt“.
Diese Information kann selbst einen eigenen Alarmzustand auslösen. Bei einer wichtigen Messstelle kann eine länger fehlende Aktualisierung mindestens genauso relevant sein wie eine Grenzwertüberschreitung.
Ein System sollte deshalb neben Prozessalarmen auch Datenqualitäts- und Kommunikationsalarme kennen.
Das gilt ebenso für Sicherheits- oder Schutzentscheidungen. Interpolierte Werte sollten nicht ohne ausdrücklich dafür vorgesehenes Konzept verwendet werden, um fehlende reale Messungen in sicherheitsrelevanten Entscheidungen zu ersetzen.
Ein robustes Datenmodell für Messwerte aufbauen
Für viele IIoT-Anwendungen reicht ein einfaches Datenpaar aus Zeitstempel und Zahlenwert langfristig nicht aus.
Ein belastbarer Datensatz kann beispielsweise logisch folgende Informationen enthalten:
{
  "timestamp": "2026-09-25T08:15:00.000Z",
  "value": 6.24,
  "unit": "bar",
  "quality": "good",
  "source": "pressure_101",
  "received_at": "2026-09-25T08:15:00.240Z",
  "origin": "measured"
}
Bei einem fehlenden Wert muss nicht zwangsläufig ein künstlicher Datensatz erzeugt werden. Falls das Datenmodell explizite Zeitraster verwendet, könnte ein Datensatz dagegen beispielsweise einen NULL-Wert mit dem Qualitätsstatus „missing“ enthalten.
Ein interpolierter Datensatz könnte zusätzlich die Herkunft „calculated“ und die verwendete Methode enthalten. Dadurch bleibt er auch nach mehreren Verarbeitungsschritten von einem Sensorwert unterscheidbar.
In umfangreicheren Systemen können zusätzlich Sequenznummern, Geräte-ID, Firmwarestand, Kommunikationsstatus oder Unsicherheitsinformationen sinnvoll sein.
Welche Felder tatsächlich erforderlich sind, hängt von der Anwendung ab. Entscheidend ist, dass die spätere Bedeutung eines Datenpunktes nicht ausschließlich aus dem Zahlenwert erraten werden muss.
Praxisbeispiel einer Druckzeitreihe
Ein Prozessdruck wird einmal pro Minute erfasst. Das definierte Messintervall erlaubt deshalb eine eindeutige Aussage darüber, wann ein Messwert erwartet wird.
| Zeit | Rohwert | Qualität | Interpretation |
|---|---|---|---|
| 10:00 | 5,20 bar | Good | Tatsächlich gemessen |
| 10:01 | 5,22 bar | Good | Tatsächlich gemessen |
| 10:02 | – | Missing | Kein Messwert verfügbar |
| 10:03 | – | Missing | Kein Messwert verfügbar |
| 10:04 | 5,28 bar | Good | Tatsächlich gemessen |
| 10:05 | 0,00 bar | Good | Realer Nullwert, beispielsweise Anlage drucklos |
Für eine reine Trenddarstellung könnte zwischen 10:01 und 10:04 beispielsweise linear interpoliert werden. Dann würden für 10:02 und 10:03 rechnerische Werte entstehen.
Diese Werte sollten jedoch nicht die beiden „Missing“-Einträge der Rohdaten ersetzen.
Die Darstellungsebene kann vielmehr eine zweite Sicht erzeugen:
10:02 → 5,24 bar → interpoliert
10:03 → 5,26 bar → interpoliert
Der Wert von 0,00 bar um 10:05 bleibt dagegen ein echter Messwert und darf weder als fehlend entfernt noch mit dem letzten Wert überschrieben werden.
Dadurch kann dasselbe System gleichzeitig eine leicht lesbare Trendkurve und eine technisch korrekte Datenhistorie bereitstellen.
Lücken bereits in der IIoT-Architektur beherrschen
Eine saubere Lückenbehandlung beginnt nicht erst im Dashboard. Sie sollte bereits beim Entwurf der Datenkette berücksichtigt werden.
Eine typische Architektur kann beispielsweise so aussehen:
Sensor → SPS / Feldbus → Edge-Gateway → lokaler Puffer → MQTT / OPC UA → Historian → Dashboard / Analyse
Auf der Sensor- beziehungsweise Steuerungsebene sollte möglichst klar sein, wie häufig Werte tatsächlich erfasst werden und ob ein Diagnose- oder Qualitätsstatus existiert.
Die Edge-Ebene kann anschließend eine besonders wichtige Rolle übernehmen. Sie kann Zeitstempel harmonisieren, Werte skalieren, Qualitätsinformationen übernehmen, Kommunikation überwachen und bei unterbrochener Verbindung Daten lokal puffern.
Bei der Übertragung sollte der ursprüngliche Messzeitpunkt erhalten bleiben. Eine spätere Weiterleitung darf nicht dazu führen, dass gepufferte Daten einen neuen Zeitpunkt erhalten und dadurch die Historie verschoben wird.
Im Historian muss wiederum klar definiert sein, wie verspätete und doppelte Datenpunkte behandelt werden. Die Visualisierung entscheidet schließlich, ob eine Lücke sichtbar bleibt oder für bestimmte Darstellungen interpoliert wird.
Damit besitzt jede Ebene eine andere Aufgabe. Wird die Interpolation beispielsweise bereits im Edge-Gateway vorgenommen und nur noch der berechnete Wert an die Cloud übertragen, kann die Cloud später möglicherweise nicht mehr erkennen, dass ursprünglich ein Sensorwert fehlte.
Für nachvollziehbare Systeme sollte deshalb möglichst lange zwischen Erfassung, Qualitätsbewertung und Darstellung unterschieden werden.
Wo ist der Messwert verloren gegangen?
Eine Datenlücke sagt zunächst lediglich aus, dass am betrachteten Punkt der Architektur ein erwarteter Wert nicht vorhanden ist. Sie erklärt noch nicht die Ursache.
Der Sensor selbst kann ausgefallen sein. Die SPS kann eine ungültige Eingangsqualität erhalten haben. Ein Modbus-Telegramm kann nicht beantwortet worden sein. Das Edge-Gateway kann während eines Neustarts keine Daten erfasst haben. Der lokale Speicher kann voll gewesen sein. Eine MQTT-Verbindung kann unterbrochen worden sein oder der Historian kann Daten wegen eines Schemafehlers abgelehnt haben.
Für eine belastbare Ursachenanalyse sollte deshalb neben dem eigentlichen Prozesswert auch die technische Datenkette beobachtbar sein.
Besonders hilfreich ist es, unterscheiden zu können, ob der letzte gültige Sensorwert beispielsweise um 12:01 Uhr erfasst wurde, das Gateway aber noch bis 12:10 Uhr online war. In diesem Fall liegt der Fehler wahrscheinlich näher an der Sensor- oder Feldebene als an der Cloud-Verbindung.
Umgekehrt kann ein Gateway während des gesamten Ausfalls weiter Daten puffern. Dann ist der Sensorpfad intakt und nur der Übertragungsweg gestört.
Genau deshalb sind Kommunikationsstatus, Buffer-Füllstand und Zeitstempel nicht ausschließlich IT-Informationen. Sie sind Bestandteil der Messdatenqualität.
IT/OT-Betrieb und Datenqualität gemeinsam überwachen
In vielen Projekten endet die technische Arbeit mit dem ersten erfolgreichen Dashboard. Für dauerhaft verwertbare Zeitreihen beginnt an diesem Punkt jedoch erst der Betrieb.
Eine Datenplattform sollte erkennen können, wenn sich die Aktualisierungsrate einer Messstelle plötzlich verändert. Ein Sensor, der normalerweise jede Sekunde einen Wert liefert und seit zehn Minuten still ist, benötigt eine andere Aufmerksamkeit als eine Messstelle, die konstruktiv nur einmal pro Stunde sendet.
Auch die Edge-Pufferung sollte überwacht werden. Ein Gateway kann zunächst problemlos offline weiterarbeiten. Füllt sich der lokale Speicher jedoch zunehmend, entsteht ein Zeitpunkt, an dem tatsächlich Daten verloren gehen können.
Nach Wiederherstellung einer Verbindung sollte außerdem sichtbar sein, ob der Rückstau vollständig übertragen wurde. Eine grüne Online-Anzeige allein beweist noch nicht, dass die historische Lücke geschlossen wurde.
Für IT/OT-Teams ist deshalb eine eigene Datenqualitätsüberwachung sinnvoll. Sie bewertet nicht nur, ob Geräte erreichbar sind, sondern ob die erwarteten Daten vollständig, zeitlich plausibel und mit gültigem Qualitätsstatus im Zielsystem ankommen.
Damit wird Datenqualität zu einer laufenden Betriebsgröße statt zu einem Problem, das erst Monate später bei einer Analyse auffällt.
Häufige Fehler in der Praxis
Fehlende Werte automatisch mit 0 füllen
Dadurch wird aus fehlender Information ein realer Prozesswert. Verbräuche, Mittelwerte, Stillstandszeiten und Alarmzustände können dadurch erheblich verfälscht werden.
Jeden Nullwert als fehlerhaften Datensatz entfernen
Ein Wert von 0 kann ein vollständig gültiger Betriebszustand sein. Datenbereinigung darf nicht allein anhand des Zahlenwertes entscheiden, ob ein Messpunkt plausibel ist.
Interpolation durchführen und die Herkunft anschließend vergessen
Ein berechneter Wert sollte dauerhaft als interpoliert beziehungsweise geschätzt erkennbar bleiben. Er darf nicht unbemerkt zum vermeintlichen Rohmesswert werden.
Jede längere Zeit ohne Datensatz als Kommunikationslücke interpretieren
Bei Change-of-Value- oder ereignisgesteuerten Daten kann eine lange Zeitspanne ohne neuen Datensatz dem vorgesehenen Verhalten entsprechen. Die erwartete Datenstrategie muss bekannt sein.
Verspätete Daten mit dem Empfangszeitpunkt speichern
Dadurch verschiebt sich die Messhistorie. Gepufferte Werte sollten soweit möglich ihren ursprünglichen Erfassungszeitpunkt behalten.
Aus einem unvollständigen Zeitfenster einen normalen Mittelwert erzeugen
Ein Aggregat sollte erkennen lassen, ob beispielsweise 60, 40 oder nur fünf der erwarteten Messwerte zur Berechnung zur Verfügung standen.
Den letzten bekannten Wert unbegrenzt weiter anzeigen
Ein Dashboard kann dadurch einen Stunden alten Messwert so darstellen, als wäre er aktuell. Ein Stale- beziehungsweise Age-Status verhindert diese Fehlinterpretation.
Interpolation für Alarm- oder Sicherheitsentscheidungen verwenden
Eine mathematische Schätzung ersetzt keine tatsächliche Messung. Für kritische Entscheidungen muss klar definiert sein, wie fehlende Daten behandelt werden und welcher Zustand bei Verlust der Messinformation entsteht.
Passende IIoT-Lösungen bei ICS Schneider
ICS Schneider Messtechnik unterstützt IIoT-Architekturen vom Feldgerät über Edge- und Gateway-Systeme bis zu übergeordneten IT-, SCADA-, Historian- und Cloud-Anwendungen.
Unter IIoT-Lösungen werden Sensorik und vorhandene Feldgeräte über industrielle Schnittstellen und Protokolle in eine übergeordnete Datenarchitektur integriert. Dabei können Aufgaben wie Skalierung, Zeitstempelung, Datenmodellierung, Pufferung, Qualitätsabbildung und sichere Weiterleitung eine zentrale Rolle spielen.
Für lokale Messwerterfassung stehen außerdem unterschiedliche Datenlogger und Universalmessgeräte zur Verfügung. Gerade bei Anwendungen mit instabiler Netzwerkverbindung kann eine lokale Aufzeichnung helfen, die eigentliche Erfassung von der späteren Datenübertragung zu trennen.
Für ein IIoT-Projekt sollte deshalb nicht nur gefragt werden, welcher Sensor und welches Kommunikationsprotokoll verwendet werden. Ebenso wichtig ist die Festlegung, wo Zeitstempel erzeugt werden, ob lokale Datenpuffer vorhanden sind, wie Qualitätszustände transportiert werden und was bei einer unterbrochenen Verbindung mit den Messwerten geschieht.
Eine robuste Datenarchitektur definiert außerdem, wie verspätete Datensätze, Duplikate und Datenlücken behandelt werden und ob interpolierte Werte lediglich für die Darstellung oder auch für weiterführende Analysen verwendet werden dürfen.
IIoT-Lösungen bei ICS Schneider
Weiterführend: Messdaten am Edge verdichten
Weiterführend: Zeitstempel für IIoT-Messdaten – Sensor, SPS oder Gateway?
Weiterführend: Edge-Pufferspeicher dimensionieren
Weiterführend: Change-of-Value statt festem Sendeintervall
Fazit
Eine Datenlücke ist kein Zahlenwert. Diese einfache Aussage ist die Grundlage einer belastbaren industriellen Zeitreihe.
Ein echter Nullwert, ein fehlender Messwert, ein ungültiger Sensorwert und ein interpolierter Ersatzwert beschreiben vier unterschiedliche Situationen und sollten im Datenmodell auch als solche erkennbar bleiben.
Der Unterschied wirkt sich unmittelbar auf Mittelwerte, Verbräuche, Maschinenzustände, Alarmierung und spätere Analysen aus. Wird fehlende Information mit 0 ersetzt, können künstliche Stillstände entstehen. Wird dagegen jeder Nullwert verworfen, gehen reale Betriebszustände verloren.
Interpolation kann die Darstellung und bestimmte analytische Aufgaben verbessern, darf aber die Herkunft des Datenpunktes nicht verschleiern. Der ursprüngliche Rohdatensatz sollte möglichst unverändert erhalten bleiben, während berechnete Werte eindeutig als abgeleitet gekennzeichnet werden.
Ebenso wichtig ist der Zeitbezug. Ein verspätet übertragener Wert ist nicht automatisch ein fehlender Messwert. Wird er am Edge gepuffert und behält seinen ursprünglichen Erfassungszeitpunkt, kann er später korrekt in die historische Zeitreihe eingeordnet werden.
Bei Change-of-Value- und ereignisbasierten Messungen ist schließlich auch das Fehlen neuer Datensätze nicht automatisch eine Lücke. Erst die definierte Erfassungs- und Übertragungsstrategie legt fest, wann ein Messwert tatsächlich erwartet wurde.
Für industrielle IIoT-Systeme bedeutet das: Datenqualität beginnt nicht im Dashboard. Sensor, Zeitstempel, Qualitätsstatus, Edge-Puffer, Kommunikationsweg, Historian und Auswertelogik bilden gemeinsam eine Messdatenkette.
Wer diese Kette so aufbaut, dass „gemessen“, „fehlend“, „ungültig“ und „berechnet“ dauerhaft unterscheidbar bleiben, erhält Zeitreihen, die auch Jahre später noch belastbar analysiert werden können.
FAQ zu Lücken in industriellen Zeitreihen
Ist ein fehlender Messwert dasselbe wie 0?
Nein. 0 ist ein numerischer Messwert. Ein fehlender Messwert bedeutet, dass für den betreffenden Zeitpunkt keine belastbare Messinformation vorhanden ist.
Wann sollte ein fehlender Wert als NULL gespeichert werden?
Das hängt vom Datenbanksystem und Datenmodell ab. Entscheidend ist, dass NULL beziehungsweise das Fehlen des Datensatzes eindeutig als „kein Messwert vorhanden“ interpretiert wird und nicht mit dem Zahlenwert 0 verwechselt werden kann.
Was ist der Unterschied zwischen fehlend und ungültig?
Bei einem fehlenden Wert steht kein Messwert zur Verfügung. Bei einem ungültigen Wert hat möglicherweise eine Messwerterfassung stattgefunden, die Datenquelle kennzeichnet das Ergebnis jedoch aufgrund eines Sensor-, Bereichs- oder Diagnosefehlers als nicht vertrauenswürdig.
Was bedeutet ein Stale-Wert?
Ein Stale-Wert ist ein früherer Messwert, der weiterhin dargestellt wird, obwohl seit längerer Zeit keine Aktualisierung eingetroffen ist. Er sollte nicht so erscheinen, als handele es sich um einen aktuellen Messwert.
Darf man fehlende Werte interpolieren?
Für bestimmte Analyse- und Darstellungszwecke ja. Die Zulässigkeit hängt von Messgröße, Lückendauer und Anwendung ab. Der interpolierte Wert sollte jedoch eindeutig als berechnet gekennzeichnet bleiben.
Wann eignet sich lineare Interpolation?
Am ehesten bei kurzen Lücken in langsam und kontinuierlich veränderlichen Größen. Bei schnellen Ereignissen, Sprüngen oder Spitzen kann eine lineare Interpolation den tatsächlichen Verlauf stark verfälschen.
Was ist Forward Fill?
Dabei wird der letzte bekannte Wert bis zum nächsten Datenpunkt weitergeführt. Das kann bei zustandsorientierten Daten korrekt sein, stellt bei kontinuierlichen analogen Messgrößen jedoch eine zusätzliche Annahme über den Verlauf dar.
Darf ein interpolierter Wert in die Rohdatentabelle geschrieben werden?
Technisch ist das möglich, für die Rückverfolgbarkeit jedoch problematisch, wenn anschließend nicht mehr erkennbar ist, dass der Wert berechnet wurde. Eine getrennte Roh- und Verarbeitungsebene oder zumindest eine eindeutige Herkunftskennzeichnung ist robuster.
Warum ist der Source Timestamp wichtig?
Er ordnet den Wert dem Zeitpunkt seiner eigentlichen Erfassung zu. Bei gepufferten oder verspätet übertragenen Daten verhindert er, dass der spätere Empfangszeitpunkt fälschlich als Messzeit verwendet wird.
Ist ein Netzwerkausfall automatisch eine Datenlücke?
Nicht unbedingt. Wenn Sensor beziehungsweise Edge-Gateway während des Ausfalls weiter messen und die Werte lokal persistent puffern, können die Daten nach Wiederherstellung der Verbindung vollständig nachgetragen werden.
Was passiert mit nachträglich übertragenen Messwerten?
Sie sollten anhand ihres ursprünglichen Messzeitpunktes in die historische Zeitreihe eingeordnet werden. Das Zielsystem sollte außerdem mit verspäteten und gegebenenfalls mehrfach übertragenen Datensätzen umgehen können.
Wie unterscheidet man einen Messausfall von einem Kommunikationsausfall?
Dazu sind zusätzliche Diagnoseinformationen hilfreich. Sensorstatus, Feldbusstatus, Gateway-Zustand, Pufferbelegung und Empfangszeiten können zeigen, auf welcher Ebene der Datenkette die Unterbrechung entstanden ist.
Ist eine lange Zeit ohne neuen Wert immer eine Lücke?
Nein. Bei Change-of-Value- oder ereignisbasierten Übertragungen kann das Ausbleiben eines neuen Datensatzes bedeuten, dass sich der Prozesswert nicht ausreichend verändert hat. Die erwartete Übertragungslogik muss bekannt sein.
Wie kann man bei Change-of-Value einen Kommunikationsausfall erkennen?
Zusätzliche Heartbeats, Gerätestatusmeldungen oder definierte maximale Aktualisierungsintervalle können zeigen, dass das Gerät weiterhin erreichbar ist, obwohl kein neuer Prozesswert übertragen wurde.
Wie sollten Mittelwerte bei unvollständigen Daten behandelt werden?
Zusätzlich zum berechneten Mittelwert sollte bekannt sein, wie viele Messwerte erwartet und wie viele tatsächlich verwendet wurden. Ein Mittelwert aus einem nahezu vollständigen Zeitfenster besitzt eine andere Datenqualität als derselbe Zahlenwert aus wenigen Einzelmessungen.
Sollten fehlende Werte bei Alarmen als 0 behandelt werden?
Nein. Ein fehlender Wert bedeutet zunächst „Zustand unbekannt“. Bei wichtigen Messstellen kann der Verlust aktueller Daten selbst ein Alarm- oder Diagnoseereignis sein.
Dürfen interpolierte Werte für Sicherheitsentscheidungen verwendet werden?
Eine rechnerische Schätzung ist kein Ersatz für eine tatsächlich verfügbare sicherheitsrelevante Messung. Die Behandlung fehlender Werte muss für die konkrete Sicherheitsfunktion ausdrücklich definiert sein.
Welche Informationen sollte ein IIoT-Messwert mindestens enthalten?
Neben dem Zahlenwert sind insbesondere ein eindeutiger Zeitstempel, Einheit beziehungsweise Messgrößenkontext und ein Qualitäts- beziehungsweise Herkunftsstatus hilfreich. Je nach Architektur können zusätzlich Empfangszeit, Geräte-ID, Sequenznummer oder Diagnosezustände sinnvoll sein.
Warum sollte die Lückenstrategie pro Messgröße definiert werden?
Temperatur, Zählerstände, digitale Schaltzustände, Vibration und schnelle Prozessgrößen besitzen völlig unterschiedliche zeitliche Eigenschaften. Eine einzige globale Interpolations- oder Fill-Regel kann deshalb technisch falsche Ergebnisse erzeugen.
Was ist das wichtigste Prinzip für historische Messdaten?
Die ursprüngliche Information sollte erhalten bleiben. Ein späterer Benutzer muss unterscheiden können, ob ein Wert tatsächlich gemessen wurde, nicht vorhanden war oder nachträglich durch eine Berechnung entstanden ist.