

Ein Industrieunternehmen überwacht den Druck und die Temperatur von mehreren Maschinen. Die Sensorwerte werden im Sekundentakt über eine SPS und ein Edge-Gateway erfasst und an eine zentrale IIoT-Plattform übertragen. Während der ersten Wochen arbeitet das System problemlos. Die Messwerte erscheinen in Echtzeit auf den Dashboards, kurze Druckschwankungen lassen sich nachvollziehen und die Instandhaltung kann historische Betriebszustände untersuchen.
Nach einigen Monaten wächst die Datenbank jedoch erheblich. Immer mehr Messstellen werden eingebunden, zusätzliche Maschinen übertragen ihre Werte und historische Auswertungen benötigen zunehmend Ressourcen. Für einen Energiebericht über das vergangene Jahr müssen plötzlich Millionen einzelner Messpunkte verarbeitet werden, obwohl für diese Auswertung häufig bereits Stunden- oder Tagesstatistiken ausreichen würden.
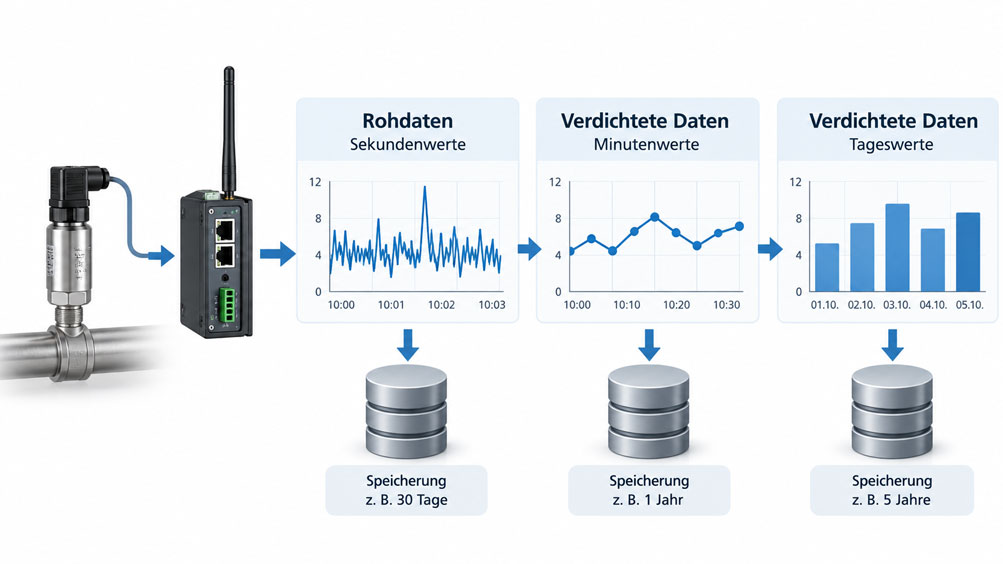
Die naheliegende Lösung besteht darin, ältere Daten zu verdichten. Aus vielen einzelnen Sekundenwerten werden beispielsweise Minutenmittelwerte sowie die zugehörigen Minima und Maxima berechnet. Für langfristige Auswertungen können daraus weitere Tagesstatistiken entstehen. Die hochaufgelösten Rohdaten werden anschließend nur noch für einen begrenzten Zeitraum vorgehalten.
Eine solche Datenverdichtung muss jedoch fachgerecht geplant werden. Wird lediglich ein Mittelwert gespeichert, können kurze Druckspitzen, Temperaturüberschreitungen oder andere relevante Prozessereignisse verschwinden. Auch Datenlücken können in einem scheinbar plausiblen Tagesmittelwert verborgen bleiben. Besonders kritisch ist das, wenn die verdichteten Daten später für Ursachenanalysen, Qualitätsnachweise oder die Beurteilung von Anlagenstörungen verwendet werden sollen.
Hinzu kommt die Frage, wann Rohdaten tatsächlich gelöscht werden dürfen. Eine automatische Retention-Regel kann Daten dauerhaft entfernen, obwohl eine Aggregation noch nicht vollständig berechnet wurde oder verspätet eintreffende Messwerte noch berücksichtigt werden müssen. Deshalb müssen Datenerfassung, Aggregation, Aufbewahrung und Löschung als zusammenhängender Prozess betrachtet werden.
Dieser Fachbeitrag erklärt, wie sich Rohdaten, Minutenwerte und Tagesstatistiken mit unterschiedlichen Aufbewahrungsfristen speichern lassen. Im Mittelpunkt stehen Datenmodell, Zeitstempel, Aggregationsfunktionen, Datenqualität, Zeitfenster, Edge-Pufferung und die sichere Löschung alter Messwerte. Ein Rechenbeispiel mit 100 industriellen Messkanälen zeigt, wie stark sich die Anzahl gespeicherter Datensätze durch eine abgestufte Retention reduzieren lässt. Zusätzlich werden typische Fehler, eine geeignete IIoT-Architektur sowie passende Mess- und Kommunikationslösungen aus dem ICS-Sortiment beschrieben.
Inhaltsverzeichnis
- Die Messaufgabe und den späteren Informationsbedarf definieren
- Rohdaten, bereinigte Messdaten und verdichtete Daten unterscheiden
- Retention als eigenständige Regel für die Datenaufbewahrung verstehen
- Sekunden-, Minuten- und Tageswerte mit unterschiedlichen Aufgaben speichern
- Messintervall, Übertragungsintervall und Speicherintervall unterscheiden
- Mittelwert, Minimum, Maximum und Anzahl der Messwerte richtig berechnen
- Zeitfenster, Zeitstempel und Zeitzonen eindeutig definieren
- Rechenbeispiel: Datenmenge bei 100 Messkanälen über fünf Jahre
- Kurze Druckspitzen und andere Extremwerte bei der Verdichtung erhalten
- Datenlücken, ungültige Messwerte und Vollständigkeit dokumentieren
- Arithmetische und zeitgewichtete Mittelwerte unterscheiden
- Mehrstufige Aggregation ohne systematische Rechenfehler durchführen
- Ein Datenmodell für Rohwerte und Aggregate festlegen
- Messzeitpunkt, Empfangszeitpunkt und Aggregationszeitraum trennen
- Edge-Gateway, lokale Pufferung und spätere Datenübertragung berücksichtigen
- Zeitreihendatenbank, Historian und getrennte Retention-Regeln auswählen
- Aggregationsaufträge und automatische Löschung sicher koordinieren
- Alarme, Zustandswechsel und Störungsereignisse gesondert archivieren
- Einheiten, Skalierungen und Berechnungsverfahren versionieren
- Eine abgestufte Retention systematisch einführen und überprüfen
- Typische Fehlerbilder bei Datenverdichtung und Aufbewahrung erkennen
- Passende IIoT-Messtechnik und Integrationslösungen von ICS Schneider
- Fazit: Speicherdauer nach Informationswert statt nur nach Datenmenge planen
- Häufige Fragen zu Rohdaten, Datenverdichtung und Retention
1. Die Messaufgabe und den späteren Informationsbedarf definieren
Vor der Festlegung einer Retention-Strategie muss bekannt sein, wofür die gespeicherten Messdaten später verwendet werden sollen.
Ein Drucksensor kann beispielsweise ausschließlich zur Anzeige des aktuellen Betriebsdrucks dienen. Dieselbe Messgröße kann jedoch auch für die Analyse von Druckspitzen, zur Berechnung von Betriebskennzahlen oder zur Dokumentation bestimmter Prozessbedingungen benötigt werden.
Diese Aufgaben stellen unterschiedliche Anforderungen an die zeitliche Auflösung und die Aufbewahrungsdauer.
Für eine aktuelle Prozessanzeige kann ein Messwert im Sekundenabstand sinnvoll sein.
Für einen langfristigen Trendbericht können dagegen Minuten- oder Stundenwerte ausreichen.
Für eine nachträgliche Untersuchung eines kurzzeitigen Maschinenfehlers können wiederum die ursprünglichen hochaufgelösten Messdaten erforderlich sein.
Deshalb sollte die Retention nicht pauschal für sämtliche Messkanäle identisch festgelegt werden.
Stattdessen sind die Anforderungen jeder relevanten Messgrößengruppe zu betrachten.
Besonders wichtig ist die Unterscheidung zwischen normalen Prozesswerten und sicherheits- beziehungsweise qualitätsrelevanten Informationen.
Ein langfristiger Temperaturtrend kann möglicherweise mit Tagesmittelwerten ausreichend beschrieben werden.
Für die Untersuchung einer kurzzeitigen Temperaturüberschreitung können dagegen Minima, Maxima, Ereigniszeiten oder hochaufgelöste Messwerte notwendig sein.
Auch mögliche gesetzliche oder vertragliche Dokumentationspflichten müssen berücksichtigt werden.
Ein technisch sinnvolles Beispiel für die Datenaufbewahrung ist nicht automatisch mit den geltenden Archivierungspflichten einer bestimmten Branche gleichzusetzen.
Die Messaufgabe bestimmt deshalb, welche Informationen erhalten bleiben müssen und welche zeitliche Auflösung später entfallen darf.
2. Rohdaten, bereinigte Messdaten und verdichtete Daten unterscheiden
In einer IIoT-Anwendung entstehen häufig mehrere aufeinander aufbauende Datenformen.
Die erste Ebene umfasst die ursprünglich erfassten Messwerte.
Diese werden im Zusammenhang mit der Datenspeicherung üblicherweise als Rohdaten bezeichnet.
Je nach System können dies digitale Sensorwerte, übertragene Prozesswerte oder bereits durch das Feldgerät skalierte Messwerte sein.
Der Begriff Rohdaten bedeutet deshalb nicht automatisch, dass noch unverarbeitete elektrische ADC-Zählwerte vorliegen.
Entscheidend ist, welche Daten tatsächlich als unveränderte Eingangswerte des betrachteten Archivierungssystems gespeichert werden.
Eine zweite Ebene können qualitätsgeprüfte oder normalisierte Messdaten bilden.
Hier werden beispielsweise Einheiten vereinheitlicht, ungültige Messwerte gekennzeichnet oder die Werte einem einheitlichen Datenmodell zugeordnet.
Solche Verarbeitungsschritte sollten nachvollziehbar bleiben.
Die dritte Ebene umfasst verdichtete Daten.
Bei der Datenverdichtung werden mehrere Einzelmessungen innerhalb eines Zeitfensters durch geeignete statistische Kennwerte beschrieben.
Beispielsweise können aus 60 Sekundenwerten ein Minutenmittelwert, ein Minimum und ein Maximum berechnet werden.
Aus diesen Minutenstatistiken lassen sich anschließend Tageswerte ableiten, sofern die Aggregationsmethode dafür geeignet ist.
Dieser Vorgang wird auch als Aggregation oder Downsampling bezeichnet.
Die Datenmenge wird dadurch häufig erheblich reduziert.
Gleichzeitig gehen jedoch Informationen verloren, die in den gespeicherten Aggregaten nicht enthalten sind.
Aus einem Minutenmittelwert kann beispielsweise nicht mehr zuverlässig rekonstruiert werden, zu welchem Zeitpunkt innerhalb der Minute eine Druckspitze aufgetreten ist.
Eine sorgfältige Retention-Strategie legt deshalb ausdrücklich fest, welche Informationen bei jeder Verdichtungsstufe erhalten bleiben müssen.
3. Retention als eigenständige Regel für die Datenaufbewahrung verstehen
Retention bezeichnet die definierte Aufbewahrungsdauer von Daten.
In einer Zeitreihendatenbank können beispielsweise Messwerte automatisch gelöscht werden, sobald sie älter als eine festgelegte Zeitgrenze sind.
Die entsprechende Regel wird als Retention Policy bezeichnet.
Ein einfaches Beispiel besteht darin, hochaufgelöste Rohdaten für 30 Tage zu speichern.
Ältere Rohdaten werden nach Ablauf dieser Frist aus dem betreffenden Speicherbereich entfernt.
Die zuvor berechneten Minuten- und Tagesstatistiken können unabhängig davon wesentlich länger aufbewahrt werden.
Diese Strategie reduziert langfristig den Speicherbedarf, ohne sämtliche Informationen über den Prozessverlauf zu verlieren.
Besonders wichtig ist die Unterscheidung zwischen Datenverdichtung und Retention.
Die Aggregation erzeugt neue statistische Datensätze aus vorhandenen Messwerten.
Die Retention bestimmt dagegen, wann Datensätze aus einer bestimmten Speicherebene entfernt werden.
Beide Prozesse müssen aufeinander abgestimmt sein.
Werden Rohdaten gelöscht, bevor die zugehörigen Aggregate vollständig erzeugt und überprüft wurden, können historische Informationen unwiederbringlich verloren gehen.
Auch eine automatische Retention ist kein Ersatz für eine Datensicherung.
Backups dienen der Wiederherstellung nach Fehlern oder Datenverlusten. Retention bestimmt die reguläre Lebensdauer der Daten im Archiv.
Beide Funktionen benötigen eigene Regeln.
Die Aufbewahrungsdauer sollte deshalb als ausdrücklich dokumentierte Betriebseinstellung und nicht als beliebiger Standardwert der Datenbank behandelt werden.
4. Sekunden-, Minuten- und Tageswerte mit unterschiedlichen Aufgaben speichern
Eine abgestufte Messdatenarchivierung verwendet mehrere zeitliche Auflösungen parallel.
Eine mögliche Struktur besteht aus hochaufgelösten Rohdaten, Minutenaggregaten und Tagesstatistiken.
Die jeweiligen Datenebenen übernehmen unterschiedliche Aufgaben.
| Datenebene | Zeitliche Auflösung | Beispielhafte Aufbewahrung | Gespeicherte Informationen | Typischer Zweck |
|---|---|---|---|---|
| Rohdaten | 1 Sekunde | 30 Tage | Einzelwert, Messzeitstempel, Qualitätsstatus, Messstellen-ID | Fehleranalyse, hochaufgelöste Trends, kurzfristige Prozessdiagnose |
| Minutenwerte | 1 Minute | 365 Tage | Mittelwert, Minimum, Maximum, Anzahl gültiger Werte, Datenqualität | Schichtauswertung, Instandhaltung, mittel- und langfristige Trendanalyse |
| Tageswerte | 1 Kalendertag | 5 Jahre | Geeignete Tagesstatistiken, Extremwerte, Vollständigkeit, gegebenenfalls Summen | Langzeitberichte, Energieanalysen, Anlagenvergleiche und historische Kennzahlen |
Die angegebenen Aufbewahrungsfristen sind frei gewählte technische Beispielwerte.
Sie stellen weder eine gesetzliche Vorgabe noch eine allgemeingültige Empfehlung für jede Messstelle dar.
Bei bestimmten Anwendungen können hochaufgelöste Daten über wesentlich längere Zeiträume notwendig sein.
Andererseits benötigen langsam veränderliche Prozessgrößen möglicherweise keine Erfassung im Sekundentakt.
Die zeitlichen Ebenen müssen deshalb aus der tatsächlichen Messaufgabe abgeleitet werden.
Auch die Verdichtungsfunktionen können je nach Messgröße unterschiedlich sein.
Bei einem kontinuierlichen Drucksignal können Mittelwert, Minimum und Maximum sinnvoll sein.
Bei einem Energiezähler kann dagegen die Differenz zweier Zählerstände oder eine korrekt gebildete Verbrauchssumme entscheidend sein.
Für digitale Schaltzustände sind unter Umständen die Einschaltzeit, Anzahl der Zustandswechsel und Alarmereignisse wichtiger als ein gewöhnlicher arithmetischer Mittelwert.
Eine sinnvolle Retention betrachtet deshalb nicht nur die Zeitauflösung, sondern auch die Bedeutung des jeweiligen Messwerttyps.
5. Messintervall, Übertragungsintervall und Speicherintervall unterscheiden
In einer IIoT-Architektur werden die Begriffe Messintervall, Übertragungsintervall und Speicherintervall häufig gleichgesetzt.
Technisch können jedoch unterschiedliche Zeitabstände vorliegen.
Das Messintervall beschreibt, in welchem zeitlichen Abstand ein Sensor oder eine Steuerung neue Messwerte erfasst.
Das Übertragungsintervall bestimmt, wie häufig die Werte an ein übergeordnetes System weitergegeben werden.
Das Speicherintervall beschreibt, mit welcher zeitlichen Auflösung Messwerte oder Aggregate im Datenarchiv abgelegt werden.
Ein Sensor kann beispielsweise intern jede Sekunde messen, während ein Funkmodul nur alle 60 Sekunden einen Wert überträgt.
Wenn dabei lediglich der zuletzt erfasste Einzelwert gesendet wird, stehen im übergeordneten System nicht automatisch sämtliche 60 vorherigen Sekundenwerte zur Verfügung.
Auch die spätere Speicherung als Minutenwert kann diese fehlenden Einzelmessungen nicht rekonstruieren.
Anders ist die Situation, wenn das Feldgerät selbst geeignete Statistiken bildet oder alle Einzelwerte mit ihren Zeitstempeln gesammelt überträgt.
Die tatsächlich verfügbaren Informationen hängen dann vom Gerät und dem Übertragungsprotokoll ab.
Bei drahtlosen IIoT-Sensoren kann die Trennung zwischen Messung und Funkübertragung besonders wichtig sein.
Häufig werden die Übertragungsintervalle so gewählt, dass Energieverbrauch und Funkdatenmenge reduziert werden.
Ein kürzeres internes Messintervall bedeutet deshalb nicht automatisch ein gleich großes historisches Datenvolumen in der Cloud.
Für die Retention-Planung muss ausdrücklich bekannt sein, welche Werte das Archiv tatsächlich erhält.
Die vorgesehene Aggregationsauflösung darf nicht mit einer höheren physikalischen Auflösung verwechselt werden, als das Messsystem tatsächlich liefert.
6. Mittelwert, Minimum, Maximum und Anzahl der Messwerte richtig berechnen
Die Auswahl der Aggregationsfunktion ist für die Aussagekraft verdichteter Messdaten entscheidend.
Eine häufig verwendete Kennzahl ist der arithmetische Mittelwert.
Für n gültige Messwerte xi lautet er:
x̄ = (Σ xi) / n
Der Mittelwert beschreibt die durchschnittliche Höhe der berücksichtigten Messwerte.
Er enthält jedoch keine vollständige Information über die Verteilung innerhalb des Zeitfensters.
Ein einzelner hoher Druckwert kann beispielsweise durch viele niedrigere Werte im Mittelwert weitgehend verborgen bleiben.
Deshalb sollten bei geeigneten Prozessgrößen zusätzlich Minimum und Maximum gespeichert werden.
Das Minimum beschreibt den kleinsten berücksichtigten gültigen Messwert innerhalb des jeweiligen Fensters.
Das Maximum beschreibt entsprechend den größten erfassten gültigen Messwert.
Auch die Anzahl der tatsächlich verwendeten Werte ist wichtig.
Sie ermöglicht es, die Aussagekraft eines berechneten Mittelwerts besser zu beurteilen.
Bei einer Messung im Sekundentakt werden innerhalb einer vollständig erfassten Minute normalerweise 60 Messwerte erwartet.
Wenn davon nur 45 gültige Werte vorliegen, sollte diese Abweichung nicht verborgen werden.
Eine weitere wichtige Größe ist der Qualitätsstatus.
Er beschreibt beispielsweise, ob alle Werte gültig waren oder ob bestimmte Messpunkte aufgrund von Sensorfehlern oder Kommunikationsstörungen ausgeschlossen wurden.
Auch bei Extremwerten muss die Datenqualität berücksichtigt werden.
Ein als ungültig gekennzeichneter Sensorwert darf nicht ohne entsprechende Regel als tatsächliches Prozessmaximum behandelt werden.
Die OPC-UA-Spezifikation definiert für historische Aggregate ausdrücklich unterschiedliche Funktionen für Mittelwert, zeitgewichteten Mittelwert, Minimum, Maximum und weitere Statistiken sowie Regeln zur Qualitätsbewertung.
Für einen technisch belastbaren Minutenwert sind deshalb häufig mehrere zusammengehörige Kennwerte notwendig.
7. Zeitfenster, Zeitstempel und Zeitzonen eindeutig definieren
Bei der Aggregation werden Messwerte einem bestimmten zeitlichen Intervall zugeordnet.
Ein solches Intervall wird häufig als Zeitfenster oder Time Bucket bezeichnet.
Für die Verarbeitung muss eindeutig festgelegt werden, wo das Fenster beginnt und endet.
Eine typische Definition verwendet ein links geschlossenes und rechts offenes Intervall.
Beispielsweise:
[10:00:00, 10:01:00)
Dieses Zeitfenster enthält Messwerte ab 10:00:00 einschließlich, jedoch keine Messwerte mit einem Zeitstempel von 10:01:00.
Diese Zuordnung verhindert, dass Werte an Fenstergrenzen doppelt berücksichtigt werden.
Zusätzlich muss festgelegt werden, welcher Zeitstempel für das Aggregat gespeichert wird.
Häufig wird der Beginn des Zeitfensters verwendet.
Ein Minutenwert mit dem Zeitstempel 10:00:00 kann dann das Intervall von 10:00:00 bis unmittelbar vor 10:01:00 beschreiben.
Der Zeitstempel bezeichnet damit nicht zwangsläufig den tatsächlichen Zeitpunkt eines einzelnen Messwerts.
Bei Tageswerten wird die Betrachtung noch wichtiger.
Ein technischer Tag mit genau 24 Stunden ist nicht immer identisch mit einem lokalen Kalendertag.
Aufgrund der Sommerzeitumstellung kann ein lokaler Kalendertag beispielsweise 23 oder 25 Stunden enthalten.
Für die Speicherung kann eine einheitliche UTC-Zeitbasis sinnvoll sein.
Wenn jedoch ausdrücklich kalenderbezogene lokale Tagesstatistiken benötigt werden, müssen Zeitzone und Kalendergrenzen korrekt berücksichtigt werden.
Auch die Herkunft des Zeitstempels ist wichtig.
Ein Zeitstempel kann den Zeitpunkt der physikalischen Messung, den Empfang am Gateway oder den Eingang in der Cloud beschreiben.
Diese Zeitangaben sind nicht automatisch gleichwertig.
Die genaue Bedeutung sollte deshalb Teil des Datenmodells sein.
8. Rechenbeispiel: Datenmenge bei 100 Messkanälen über fünf Jahre
Ein industrieller Prüfstand besitzt 100 Messkanäle.
Jeder Kanal liefert während des gesamten betrachteten Zeitraums genau einen Messwert pro Sekunde.
Für eine vereinfachte Berechnung wird von einem kontinuierlichen Betrieb rund um die Uhr ausgegangen.
Außerdem werden Jahre mit jeweils 365 Tagen angenommen.
Schaltjahre, Datenlücken und zusätzliche Ereignisdatensätze bleiben in diesem Beispiel unberücksichtigt.
Ohne Datenverdichtung würden innerhalb eines Tages folgende Messwerte entstehen:
NTag = 100 · 86.400 = 8.640.000 Messwerte
Über fünf Jahre ergibt sich:
N5 Jahre = 100 · 86.400 · 365 · 5
N5 Jahre = 15.768.000.000 Messwerte
Die Zahl entspricht mehr als 15,7 Milliarden einzelnen Messdatensätzen.
Nun wird eine abgestufte Retention betrachtet.
Rohdaten bleiben für 30 Tage erhalten.
Zusätzlich werden Minutenaggregate für 365 Tage gespeichert.
Tagesaggregate bleiben über fünf Jahre verfügbar.
Für die folgenden Berechnungen wird angenommen, dass pro Messkanal und vollständigem Zeitfenster genau ein Aggregatdatensatz entsteht.
Dieser Datensatz kann mehrere Kennwerte enthalten, beispielsweise Mittelwert, Minimum, Maximum und Anzahl gültiger Messwerte.
Für die Rohdaten ergibt sich:
NRohdaten = 100 · 86.400 · 30 = 259.200.000
Für Minutenwerte:
NMinuten = 100 · 1.440 · 365 = 52.560.000
Für Tageswerte:
NTage = 100 · 365 · 5 = 182.500
| Speicherstrategie | Auflösung | Aufbewahrung | Gespeicherte Datensätze |
|---|---|---|---|
| Rohdatenarchiv | 1 Sekunde | 30 Tage | 259.200.000 |
| Minutenarchiv | 1 Minute | 365 Tage | 52.560.000 |
| Tagesarchiv | 1 Tag | 5 Jahre | 182.500 |
| Abgestufte Speicherung insgesamt | Mehrere Auflösungen | Je Datenebene unterschiedlich | 311.942.500 |
| Alternative: alle Rohdaten fünf Jahre speichern | 1 Sekunde | 5 Jahre | 15.768.000.000 |
Die abgestufte Strategie benötigt in diesem vereinfachten Modell rund 312 Millionen Datensätze.
Die Speicherung sämtlicher Sekundenwerte über fünf Jahre würde dagegen ungefähr 15,8 Milliarden Datensätze erfordern.
Damit reduziert sich die Anzahl gespeicherter Datensätze um ungefähr 98 %.
Wichtig ist, dass hier lediglich die Anzahl der Datensätze verglichen wird.
Ein Minutenaggregat mit mehreren statistischen Kennwerten kann mehr Speicherplatz benötigen als ein einzelner Rohdatenwert.
Außerdem beeinflussen Zeitstempel, Datenbankindizes, Kompression, Metadaten und die tatsächliche Speicherarchitektur den Platzbedarf.
Die berechnete Reduzierung der Datensatzanzahl ist daher nicht automatisch mit einer identischen prozentualen Reduzierung der Datenbankgröße oder der Betriebskosten gleichzusetzen.
Die Beispielrechnung setzt außerdem voraus, dass die Minuten- und Tagesaggregate tatsächlich erzeugt und erfolgreich gespeichert werden, bevor die benötigten Rohdaten ablaufen.
Besonders wichtig bleibt die fachliche Eignung dieser Verdichtungsstrategie.
Für Prozessereignisse, bei denen auch nach Jahren noch Sekundenwerte erforderlich sind, kann eine längere Rohdatenaufbewahrung oder ein separates Ereignisarchiv notwendig sein.
Das Rechenbeispiel beschreibt eine mögliche technische Architektur und keine allgemeingültigen Retention-Fristen.
9. Kurze Druckspitzen und andere Extremwerte bei der Verdichtung erhalten
Eine besondere Gefahr der Datenverdichtung besteht darin, dass kurze Ereignisse im Mittelwert verschwinden.
Beispielsweise kann ein Hydrauliksystem über fast eine gesamte Minute mit 120 bar arbeiten.
Während eines kurzen Moments tritt jedoch ein gemessener Druckwert von 180 bar auf.
Wird ausschließlich der Minutenmittelwert gespeichert, kann die kurzfristige Belastung später kaum noch erkannt werden.
Für bestimmte Zustands- und Verschleißanalysen kann aber gerade dieser Extremwert entscheidend sein.
Deshalb sollten bei entsprechenden Messgrößen auch Minimum und Maximum erhalten bleiben.
Ein Minutenaggregat kann somit beispielsweise folgende Informationen enthalten:
Mittelwert: 121,0 bar
Minimum: 119,5 bar
Maximum: 180,0 bar
Anzahl gültiger Werte: 60
Die Zahlen beschreiben einen frei gewählten Beispielzustand.
Zusätzlich kann es sinnvoll sein, den tatsächlichen Zeitpunkt des Extremwerts zu speichern.
Ein Maximum, das lediglich dem Beginn eines Minutenfensters zugeordnet ist, beschreibt noch nicht, wann innerhalb dieses Fensters die Druckspitze aufgetreten ist.
Für eine spätere Ursachenanalyse können daher die Zeitstempel der jeweiligen Minima und Maxima relevant sein.
Allerdings muss auch die physikalische Erfassungsrate berücksichtigt werden.
Wenn ein Sensor nur einmal pro Sekunde gemessen wird, können erheblich kürzere Druckspitzen zwischen den Messzeitpunkten unentdeckt bleiben.
Ein gespeicherter Maximalwert beschreibt deshalb zunächst den größten tatsächlich erfassten gültigen Wert.
Er ist nicht automatisch mit dem absoluten physikalischen Maximum des gesamten Prozesses gleichzusetzen.
Für sehr schnelle Druckereignisse können entsprechend schnellere Sensoren und Erfassungssysteme erforderlich sein.
Die nachträgliche Datenverdichtung kann eine unzureichende ursprüngliche Abtastrate nicht korrigieren.
10. Datenlücken, ungültige Messwerte und Vollständigkeit dokumentieren
Ein gespeicherter Mittelwert ist nur dann aussagekräftig, wenn die Qualität der zugrunde liegenden Messdaten bekannt ist.
Besonders wichtig sind fehlende, ungültige oder verspätet eintreffende Messwerte.
Ein einfaches Beispiel betrachtet eine Messstelle mit einer vorgesehenen Abtastung im Sekundentakt.
Innerhalb einer Minute wären somit 60 Messwerte zu erwarten.
Wenn aufgrund einer Kommunikationsstörung nur 50 gültige Werte vorliegen, beträgt die zahlenmäßige Vollständigkeit:
Vollständigkeit = 50 / 60 · 100 % ≈ 83,3 %
Wird aus den vorhandenen 50 Werten ein Mittelwert gebildet, kann dieser mathematisch korrekt sein.
Er beschreibt aber nicht zwangsläufig den vollständigen Zeitraum.
Besonders problematisch wäre es, den fehlenden Zeitraum ohne Kennzeichnung als normalen Prozesszustand zu behandeln.
Auch fehlende Werte dürfen nicht pauschal durch null ersetzt werden.
Bei einer Druckmessung könnte dadurch beispielsweise ein künstlich niedriger Mittelwert entstehen.
Geeignete Verfahren unterscheiden deshalb zwischen gültigen Messwerten, ungültigen Messwerten und vollständig fehlenden Daten.
Ein Aggregat sollte gegebenenfalls die Anzahl der gültigen Werte, die erwartete Anzahl und einen entsprechenden Qualitätsstatus enthalten.
Die tatsächliche Berechnung der Vollständigkeit hängt von der Art der Datenquelle ab.
Bei ereignisorientierter Übertragung gibt es nicht unbedingt ein festes Sollintervall mit einer erwarteten Zahl von Messwerten.
Bei unregelmäßiger Erfassung kann eine zeitbezogene Abdeckungsbewertung sinnvoller sein als das reine Zählen vorhandener Datenpunkte.
Für eine automatische Auswertung müssen die entsprechenden Regeln eindeutig definiert sein.
Besonders wichtig ist außerdem, dass ungültige Aggregate nicht stillschweigend als vollständig gültige Tagesstatistik weiterverarbeitet werden.
Eine unvollständige Minute muss bei der Tagesaggregation entsprechend berücksichtigt oder gekennzeichnet werden.
11. Arithmetische und zeitgewichtete Mittelwerte unterscheiden
Für die Aggregation industrieller Messwerte stehen unterschiedliche Mittelwertdefinitionen zur Verfügung.
Bei gleichmäßig verteilten, gültigen Einzelmessungen kann ein arithmetischer Mittelwert die Messwerte des betrachteten Zeitraums angemessen beschreiben.
Bei unregelmäßigen Messabständen ist diese Interpretation jedoch nicht immer korrekt.
Beispielsweise kann ein Drucksensor bei stabilen Prozessbedingungen nur selten Werte übertragen, während bei schnellen Änderungen häufiger neue Werte gesendet werden.
Ein einfacher Mittelwert über alle empfangenen Werte gewichtet dann Zeitbereiche mit vielen Messpunkten stärker.
Das muss nicht der tatsächlichen zeitlichen Verteilung des Drucks entsprechen.
Für solche Anwendungen kann ein zeitgewichteter Mittelwert sinnvoll sein.
Dabei wird berücksichtigt, wie lange bestimmte Messwerte beziehungsweise interpolierte Signalverläufe innerhalb des betrachteten Zeitfensters gelten.
Die konkrete Berechnung hängt davon ab, welches Signalmodell verwendet wird.
Bei einem stufenförmig interpretierten Signal wird beispielsweise angenommen, dass ein Messwert bis zur nächsten Aktualisierung bestehen bleibt.
Bei einem kontinuierlichen Signal kann unter geeigneten Bedingungen eine lineare Interpolation zwischen Messpunkten verwendet werden.
Beide Verfahren können unterschiedliche Ergebnisse liefern.
Deshalb muss das gewählte Berechnungsprinzip zur Messgröße und zur Art der Erfassung passen.
Auch der Umgang mit fehlenden Zeitabschnitten muss eindeutig definiert sein.
Eine lange Datenlücke darf nicht ohne geeignete Begründung durch eine beliebige Interpolation in einen scheinbar lückenlosen Prozessverlauf verwandelt werden.
Die OPC-UA-Spezifikation unterscheidet deshalb ausdrücklich zwischen dem gewöhnlichen Average-Aggregat und verschiedenen zeitgewichteten Mittelwertverfahren.
Für eine langfristige Retention sollte gespeichert werden, welches Aggregationsverfahren tatsächlich verwendet wurde.
Ein numerischer Tagesmittelwert ohne Kenntnis seiner Berechnungsmethode kann später nur eingeschränkt interpretiert werden.
12. Mehrstufige Aggregation ohne systematische Rechenfehler durchführen
Eine abgestufte IIoT-Architektur kann Tageswerte aus vorhandenen Minutenwerten erzeugen.
Diese Vorgehensweise reduziert die Anzahl der direkt zu verarbeitenden Rohdaten.
Allerdings dürfen nicht alle statistischen Kennwerte beliebig erneut aggregiert werden.
Besonders wichtig ist die korrekte Berechnung des Mittelwerts.
Wenn jede Minute dieselbe Anzahl gültiger und gleichmäßig verteilter Messwerte enthält, kann der arithmetische Mittelwert der Minutenmittelwerte dem Mittelwert aller Einzelmessungen entsprechen.
Fehlen dagegen innerhalb einzelner Minuten Messwerte, ist der einfache Mittelwert der Minutenmittelwerte möglicherweise falsch.
Für eine korrekte Zusammenfassung arithmetischer Mittelwerte sollten deshalb die Anzahl der verwendeten Werte und die jeweilige Summe berücksichtigt werden.
Die Berechnung kann vereinfacht so beschrieben werden:
x̄gesamt = Σ (ni · x̄i) / Σ ni
Dabei bezeichnet ni die Anzahl gültiger Werte und x̄i den Mittelwert des jeweiligen Teilintervalls.
Für zeitgewichtete Mittelwerte müssen dagegen geeignete Zeitgewichte beziehungsweise die zugehörigen Integrale und gültigen Zeitdauern verwendet werden.
Minima und Maxima lassen sich unter geeigneten Bedingungen einfacher über mehrere Stufen zusammenfassen.
Das Tagesminimum kann beispielsweise als Minimum der gültigen Minutenminima gebildet werden.
Das Tagesmaximum ergibt sich entsprechend aus dem Maximum der gültigen Minutenmaxima.
Diese Vorgehensweise erhält die tatsächlich erfassten Extremwerte, sofern die zugrunde liegenden Fenster und Qualitätsregeln korrekt sind.
Anders verhält es sich mit statistischen Verteilungen.
Ein Median oder ein bestimmtes Perzentil lässt sich im Allgemeinen nicht exakt aus den Mittelwerten einzelner Minuten rekonstruieren.
Wenn langfristig solche Auswertungen benötigt werden, müssen geeignete zusätzliche Kennwerte, Verteilungsinformationen oder spezielle statistische Datenstrukturen gespeichert werden.
Die Aggregation muss deshalb vor der Löschung der Rohdaten auf spätere Auswertbarkeit überprüft werden.
13. Ein Datenmodell für Rohwerte und Aggregate festlegen
Für eine zuverlässige Langzeitspeicherung reicht es nicht aus, nur Zahlenwerte und Zeitstempel abzulegen.
Besonders bei mehreren Messstellen und unterschiedlichen Aggregationsstufen muss die Bedeutung jedes Datensatzes eindeutig sein.
Ein geeigneter Rohdatensatz kann beispielsweise eine stabile Messstellen-ID, den Messwert, seine Einheit, den Erfassungszeitpunkt und einen Qualitätsstatus enthalten.
Zusätzlich können Informationen zur Sensorversion, Datenquelle und verwendeten Skalierung erforderlich sein.
Bei einem Aggregat kommen weitere Angaben hinzu.
Dazu gehören das verwendete Zeitfenster, der Aggregationstyp und die tatsächlich berücksichtigte Datenmenge.
Ein beispielhaftes Minutenaggregat könnte folgende Struktur besitzen:
Messstelle: pressure.line_01
Fensterbeginn: 2026-10-13T08:00:00Z
Fensterdauer: 60 s
Mittelwert: 8,42 bar
Minimum: 8,10 bar
Maximum: 9,35 bar
Gültige Werte: 60
Erwartete Werte: 60
Qualität: gültig
Aggregation: avg/min/max, Version 1
Die Angaben sind ein beispielhaftes Datenmodell und keine allgemein vorgeschriebene Formatdefinition.
Besonders wichtig ist die eindeutige Kennzeichnung der Auflösung.
Ein Sekundenwert und ein Tagesmittelwert dürfen nicht ohne entsprechende Metadaten als gleichartige Messpunkte behandelt werden.
Auch die Speicherung in separaten Tabellen, Buckets oder Datenbankbereichen kann sinnvoll sein.
Die konkrete Struktur hängt von der gewählten Speicherplattform ab.
Die stabilen Messstellen-IDs und die dokumentierte Aggregationssemantik sollten jedoch unabhängig von einer bestimmten Datenbanksoftware nachvollziehbar bleiben.
14. Messzeitpunkt, Empfangszeitpunkt und Aggregationszeitraum trennen
In einer verteilten IIoT-Architektur können zwischen physikalischer Messung und zentraler Speicherung erhebliche zeitliche Verzögerungen auftreten.
Ein Sensor kann beispielsweise einen Messwert um 10:00:05 erfassen.
Das Edge-Gateway empfängt ihn möglicherweise erst um 10:00:06.
Wenn zusätzlich eine Funk- oder Internetverbindung ausfällt, kann der Messwert erst wesentlich später in der zentralen Datenbank eintreffen.
Für die spätere zeitliche Auswertung ist deshalb entscheidend, welcher Zeitstempel verwendet wird.
Der physikalische Erfassungszeitpunkt sollte erhalten bleiben, soweit er aus der Datenquelle zuverlässig verfügbar ist.
Der Empfangszeitpunkt kann zusätzlich für die Diagnose der Übertragung gespeichert werden.
Beide Informationen erfüllen unterschiedliche Aufgaben.
Besonders bei verspätet eintreffenden Messwerten darf der Zeitpunkt der Cloud-Übertragung nicht ohne Weiteres den ursprünglichen Messzeitpunkt ersetzen.
Andernfalls können die Werte einem falschen Minuten- oder Tagesfenster zugeordnet werden.
Eine solche Verschiebung kann historische Prozessverläufe verändern und die zeitliche Zuordnung von Alarmereignissen erschweren.
Die Zeitbasis des Messsystems muss deshalb definiert und geeignet synchronisiert sein.
Je nach Anforderung können NTP, PTP oder die Zeitstempel einer vorgelagerten Steuerung beziehungsweise Sensorik verwendet werden.
Die erforderliche zeitliche Genauigkeit hängt von der Messaufgabe ab.
Ein langsam veränderlicher Füllstand benötigt möglicherweise eine andere Zeitgenauigkeit als die zeitliche Zuordnung schneller Maschinenereignisse.
Die Herkunft des Zeitstempels muss deshalb auch in den verdichteten Daten nachvollziehbar bleiben.
Eine ausführlichere Behandlung bietet der ICS-Fachbeitrag Zeitstempel für IIoT-Messdaten: Sensor, SPS oder Gateway?.
15. Edge-Gateway, lokale Pufferung und spätere Datenübertragung berücksichtigen
Ein Edge-Gateway verbindet industrielle Sensoren und Steuerungen mit übergeordneten IT- beziehungsweise Cloud-Systemen.
Je nach Architektur kann es Messwerte erfassen, skalieren, mit Zeitstempeln versehen und vor der Übertragung verarbeiten.
Auch eine lokale Aggregation kann sinnvoll sein.
Beispielsweise kann ein Gateway aus regelmäßig erfassten Sekundenwerten geeignete Minutenstatistiken bilden.
Dadurch lässt sich die Menge der über das Netzwerk übertragenen Daten reduzieren.
Allerdings muss geklärt werden, ob die ursprünglichen Sekundenwerte später noch benötigt werden.
Wenn das Gateway ausschließlich einen Minutenmittelwert überträgt und die Sekundenwerte sofort verwirft, können spätere Detailanalysen nicht mehr auf diese Daten zugreifen.
Bei kritischen Prozessgrößen kann daher eine zusätzliche lokale Rohdatenpufferung sinnvoll sein.
Besonders wichtig ist das Verhalten bei Kommunikationsunterbrechungen.
Eine stabile IIoT-Architektur sollte definieren, welche Daten das Gateway während einer fehlenden Verbindung zwischenspeichert.
Die Pufferkapazität muss zur maximal vorgesehenen Offline-Dauer und der erwarteten Datenmenge passen.
Nach Wiederherstellung der Verbindung können gepufferte Datensätze entsprechend dem vorgesehenen Verfahren nachgeliefert werden.
Dabei müssen ursprüngliche Zeitstempel und Datenqualität erhalten bleiben.
Zusätzlich sollte eine eindeutige Identifikation der Datensätze vorhanden sein, um bei wiederholter Übertragung unerwünschte Doppelungen zu vermeiden.
Auch der Umgang mit verspäteten Daten ist zu definieren.
Wenn ein Minutenaggregat bereits berechnet wurde, bevor alle ursprünglichen Messwerte eingetroffen sind, kann eine spätere Aktualisierung notwendig sein.
Die Retention muss dafür ein ausreichend großes zeitliches Verarbeitungsfenster bereitstellen.
Lokale Pufferung und langfristige Datenaufbewahrung sind deshalb unterschiedliche, aber eng miteinander verbundene Funktionen.
16. Zeitreihendatenbank, Historian und getrennte Retention-Regeln auswählen
Für die Speicherung industrieller Messdaten werden unterschiedliche Systeme verwendet.
Dazu gehören klassische Prozessdaten-Historians, relationale Datenbanken mit Zeitreihenfunktionen und spezialisierte Time-Series-Datenbanken.
Die konkrete Plattform beeinflusst, wie Aggregation und Retention technisch umgesetzt werden.
Ein geeignetes System sollte unterschiedliche zeitliche Auflösungen mit eigenständigen Aufbewahrungsregeln unterstützen.
Besonders vorteilhaft kann eine Trennung zwischen Rohdaten und verdichteten Daten sein.
Beispielsweise können hochaufgelöste Messwerte in einem Speicherbereich mit kurzer Retention gehalten werden.
Minuten- und Tagesaggregate können parallel in anderen Speicherbereichen mit längeren Fristen abgelegt werden.
InfluxDB beschreibt für bestimmte Produktversionen das Downsampling über zeitbasierte Aggregationsaufträge und separate Datenbereiche mit unterschiedlichen Aufbewahrungszeiten.
TimescaleDB bietet ebenfalls Funktionen für kontinuierliche Aggregate und automatische Datenaufbewahrung.
Solche Funktionen sind jedoch versions- und plattformspezifisch.
Die konkrete Konfiguration muss deshalb anhand der Dokumentation der tatsächlich verwendeten Datenbank erfolgen.
Besonders wichtig ist die Frage, wie Aggregationen nachträglich aktualisiert werden.
Wenn verspätete Messwerte eintreffen oder historische Daten korrigiert werden, kann eine erneute Berechnung der entsprechenden Zeitfenster notwendig sein.
Einige Systeme verwalten solche Änderungen automatisch innerhalb definierter Aktualisierungsfenster.
Andere Architekturen benötigen dafür gesonderte Datenverarbeitungsaufträge.
Für die Auswahl sind außerdem Schreiblast, Kompression, Abfrageleistung, Ausfallsicherheit und Exportmöglichkeiten relevant.
Die Datenbank ist damit nur ein Bestandteil der Gesamtarchitektur.
Erst die abgestimmte Kombination aus Erfassung, Datenmodell, Aggregation, Qualitätssicherung und Retention ermöglicht ein belastbares Langzeitarchiv.
17. Aggregationsaufträge und automatische Löschung sicher koordinieren
Die automatische Löschung alter Rohdaten sollte erst erfolgen, wenn ihre weitere Verwendung für die vorgesehenen Aggregationen nicht mehr notwendig ist.
Besonders bei kontinuierlicher Datenverdichtung ist die zeitliche Abstimmung wichtig.
Ein Aggregationsauftrag kann beispielsweise regelmäßig die abgeschlossenen Minutenfenster berechnen.
Ein weiterer Auftrag erzeugt daraus Tagesstatistiken.
Erst danach darf die zugehörige Rohdatenebene entsprechend ihrer definierten Retention auslaufen.
Diese einfache Reihenfolge wird anspruchsvoller, wenn Messwerte verspätet eintreffen.
Beispielsweise können während eines Netzwerkausfalls gespeicherte Rohdaten erst am folgenden Tag an die Datenbank übertragen werden.
Wenn die entsprechenden Aggregate bereits endgültig geschlossen wurden, fehlen diese Werte möglicherweise in den historischen Statistiken.
Eine robuste Architektur benötigt deshalb eine definierte Strategie für verspätete Daten.
Dazu können ausreichend große Aktualisierungsfenster, erneute Berechnungen oder eine kontrollierte Freigabe bereits abgeschlossener Zeitfenster gehören.
Auch eine nachträgliche Messwertkorrektur kann eine erneute Aggregation erforderlich machen.
Besonders wichtig ist, dass die Rohdaten-Retention mit solchen Aktualisierungsfenstern kompatibel bleibt.
TimescaleDB dokumentiert ausdrücklich, dass kontinuierliche Aggregate unter bestimmten Bedingungen ebenfalls Daten verlieren können, wenn ein Aktualisierungsfenster erneut auf bereits gelöschte Rohdaten zugreift.
Um verdichtete historische Werte dauerhaft zu erhalten, muss der Aktualisierungsbereich entsprechend begrenzt beziehungsweise mit der Rohdaten-Retention abgestimmt werden.
Auch InfluxDB weist darauf hin, dass Downsampling-Aufträge rechtzeitig vor Ablauf der Rohdaten-Retention ausgeführt werden müssen.
Deshalb sollte die automatische Löschung durch geeignete Kontrollen abgesichert werden.
Eine Retention-Regel darf nicht allein aufgrund ihres zeitlichen Ablaufs als Nachweis gelten, dass alle erforderlichen Aggregate vollständig vorhanden sind.
Besonders bei langen Aufbewahrungsfristen kann eine regelmäßige Vollständigkeitsprüfung sinnvoll sein.
18. Alarme, Zustandswechsel und Störungsereignisse gesondert archivieren
Kontinuierliche Prozessmesswerte und diskrete Ereignisse erfüllen unterschiedliche Aufgaben.
Ein Drucksensor kann beispielsweise jede Sekunde einen neuen Wert liefern.
Eine Alarmmeldung entsteht dagegen nur dann, wenn ein bestimmter Zustand erkannt wird.
Solche Ereignisse sollten nicht ausschließlich durch gewöhnliche Mittelwerte beschrieben werden.
Ein kurzer Alarmzustand kann innerhalb eines Minutenmittelwerts vollständig verborgen bleiben.
Besonders bei Störungen ist häufig wichtig, wann der Zustand begonnen hat, wie lange er bestand und wann er beendet beziehungsweise quittiert wurde.
Ein geeignetes Ereignisarchiv kann deshalb zusätzliche Informationen enthalten.
Beispiele sind Ereignis-ID, Messstellen-ID, Ereignisart, Zeitstempel, Grenzwert, tatsächlicher Messwert, Status und gegebenenfalls Quittierungsinformation.
Auch Kommunikationsausfälle und Änderungen an Gerätekonfigurationen können als Ereignisse dokumentiert werden.
Für die spätere Diagnose kann es sinnvoll sein, relevante Rohdatenabschnitte um bestimmte Ereignisse länger aufzubewahren.
Eine solche ereignisabhängige Archivierung wird häufig als Event Retention oder ereignisbezogene Speicherung bezeichnet.
Beispielsweise können die Sekundenwerte eines normalen Betriebs nach einer festgelegten Frist gelöscht werden, während die hochaufgelösten Daten bestimmter Störungsintervalle länger erhalten bleiben.
Eine solche Funktion muss technisch ausdrücklich vorgesehen sein.
Sie ergibt sich nicht automatisch aus einer gewöhnlichen zeitbasierten Retention-Regel.
Auch die Aufbewahrungsfristen der Ereignisse müssen anhand der tatsächlichen Anforderungen festgelegt werden.
Bei sicherheitsrelevanten Funktionen ist außerdem zu unterscheiden zwischen der eigentlichen zuverlässigen lokalen Alarm- beziehungsweise Schutzfunktion und der späteren Archivierung des Ereignisses.
Eine IIoT-Cloud darf nicht ohne entsprechende sicherheitstechnische Auslegung als alleiniger Schutzmechanismus verwendet werden.
19. Einheiten, Skalierungen und Berechnungsverfahren versionieren
Industrielle Messdaten können über viele Jahre hinweg gespeichert werden.
Während dieses Zeitraums können Sensoren ausgetauscht, Messbereiche verändert oder die Datenerfassung modernisiert werden.
Auch die verwendeten Einheiten und Skalierungen können sich ändern.
Ein Druckwert kann beispielsweise ursprünglich in bar gespeichert und später in Pascal weiterverarbeitet werden.
Ohne entsprechende Metadaten können historische Messwerte dadurch falsch interpretiert werden.
Bei verdichteten Daten kommt zusätzlich die Version des Aggregationsverfahrens hinzu.
Beispielsweise kann ein System zunächst arithmetische Mittelwerte berechnen und nach einer Softwareänderung auf zeitgewichtete Mittelwerte umstellen.
Die entstehenden Werte müssen nicht identisch sein.
Werden beide Berechnungsarten ohne entsprechende Kennzeichnung innerhalb einer gemeinsamen historischen Datenreihe gespeichert, kann dies zu Fehlinterpretationen führen.
Deshalb sollten wesentliche Änderungen der Berechnungsdefinition dokumentiert werden.
Dazu gehören die Aggregationsfunktion, Zeitfensterdefinition, Datenqualitätsregeln und gegebenenfalls die verwendete Softwareversion.
Auch die Behandlung von fehlenden Messwerten sollte nachvollziehbar bleiben.
Wurden früher Datenlücken durch Interpolation geschlossen und später ausdrücklich als fehlende Daten gespeichert, kann das historische Statistiken erheblich beeinflussen.
Für eine belastbare Langzeitnutzung müssen solche Unterschiede erkennbar sein.
Die Versionierung betrifft damit nicht nur die einzelnen Messwerte, sondern auch die Regeln, nach denen verdichtete Werte erzeugt wurden.
Eine ausführliche Behandlung von Einheiten und Skalierungen finden Sie im ICS-Fachbeitrag Einheiten und Skalierung in Messdaten versionieren: Bar, Pa und Rohwertfehler dauerhaft vermeiden.
20. Eine abgestufte Retention systematisch einführen und überprüfen
Die Einführung unterschiedlicher Aufbewahrungsfristen sollte als abgestimmter technischer Prozess erfolgen.
Die nachfolgenden Schritte beschreiben eine allgemeine Vorgehensweise zur Planung und Inbetriebnahme einer industriellen Messdatenarchivierung.
- Messstellen inventarisieren: Alle relevanten Sensoren, Messkanäle, Steuerungen und Datenquellen erfassen.
- Messaufgaben festlegen: Definieren, welche Daten für aktuelle Überwachung, Fehleranalyse, Reporting und Langzeitbewertung benötigt werden.
- Aufbewahrungspflichten prüfen: Vertragliche, organisatorische und gegebenenfalls gesetzliche Anforderungen an die Datenarchivierung berücksichtigen.
- Erfassungsintervalle dokumentieren: Tatsächliche Mess-, Abfrage- und Übertragungsintervalle getrennt erfassen.
- Messdatenmodell festlegen: Stabile Messstellen-IDs, Einheiten, Zeitstempel und Qualitätsinformationen definieren.
- Zeitbasis überprüfen: Herkunft und Synchronisierung der Messzeitstempel sowie die verwendete Zeitzone dokumentieren.
- Rohdatenebene definieren: Festlegen, welche ursprünglichen Daten in welcher Auflösung gespeichert werden.
- Aggregationsverfahren auswählen: Für jede Messgröße geeignete Mittelwerte, Extremwerte, Summen oder andere Kennzahlen bestimmen.
- Zeitfenster festlegen: Beginn, Ende, Dauer und Zeitstempelzuordnung der Minuten- und Tagesintervalle eindeutig definieren.
- Qualitätsregeln bestimmen: Den Umgang mit ungültigen Werten, Datenlücken und unvollständigen Fenstern dokumentieren.
- Retention je Ebene festlegen: Aufbewahrungsfristen für Rohdaten, Minutenwerte und Tagesstatistiken getrennt definieren.
- Ereignisdaten berücksichtigen: Für Alarme, Zustandswechsel und Störungen gegebenenfalls eigene Archivierungsregeln vorsehen.
- Speicherbedarf abschätzen: Erwartete Datenmengen, Kennwerte pro Aggregat und Datenbank-Overhead berücksichtigen.
- Edge-Pufferung planen: Die notwendige lokale Speicherkapazität für vorgesehene Kommunikationsunterbrechungen festlegen.
- Verspätete Daten behandeln: Nachlieferung, Duplikaterkennung und gegebenenfalls die erneute Aggregation historischer Zeitfenster definieren.
- Aggregationsaufträge konfigurieren: Die Verarbeitung in der vorgesehenen Zeitreihendatenbank beziehungsweise Datenplattform einrichten.
- Retention-Regeln abstimmen: Sicherstellen, dass erforderliche Berechnungen und Aktualisierungen vor der Rohdatenlöschung abgeschlossen sind.
- Ergebnisse vergleichen: Aggregierte Werte mit geeigneten Rohdatenintervallen prüfen und insbesondere Minima, Maxima und Vollständigkeit kontrollieren.
- Fehlerzustände testen: Kommunikationsausfälle, verspätete Datensätze, unvollständige Fenster und ausgefallene Aggregationsaufträge untersuchen.
- Produktivbetrieb dokumentieren: Retention-Fristen, Datenmodell, Aggregationsversionen, Prüfergebnisse, Verantwortlichkeiten und Änderungen nachvollziehbar festhalten.
Besonders wichtig ist, dass automatische Löschregeln nicht ungeprüft auf einen bereits bestehenden historischen Datenbestand angewendet werden.
Vor der Aktivierung müssen die Auswirkungen auf vorhandene Daten und gegebenenfalls bestehende Berichte bewertet werden.
Für eine sichere Einführung kann es sinnvoll sein, Aggregations- und Retention-Regeln zunächst mit geeigneten Testdaten zu überprüfen.
Die vollständige Qualitätssicherung umfasst nicht nur die richtige Berechnung einzelner Mittelwerte, sondern auch die langfristige Verfügbarkeit der benötigten Daten.
Regelmäßige Kontrollen der Aggregationsaufträge, Speicherauslastung und Datenvollständigkeit gehören daher zum späteren Betrieb.
21. Typische Fehlerbilder bei Datenverdichtung und Aufbewahrung erkennen
Fehler in einer Retention-Architektur entstehen häufig nicht unmittelbar bei der Messwerterfassung, sondern erst während der späteren Verarbeitung oder Löschung.
Die folgende Übersicht zeigt typische Beobachtungen und geeignete Diagnoseansätze.
| Beobachtung | Mögliche Ursache | Sinnvolle Prüfung |
|---|---|---|
| Kurze Druckspitzen sind nach der Verdichtung nicht mehr sichtbar | Es wurden ausschließlich Mittelwerte gespeichert | Minima, Maxima, Ereignisdaten und erforderliche Rohdatenaufbewahrung prüfen |
| Tagesmittelwert unterscheidet sich vom Mittelwert aller Rohdaten | Minutenmittelwerte wurden ohne geeignete Gewichtung erneut gemittelt | Aggregation anhand gültiger Wertanzahlen beziehungsweise geeigneter Zeitgewichte überprüfen |
| Tagesstatistik erscheint vollständig, obwohl mehrere Stunden fehlen | Datenlücken und unvollständige Zeitfenster wurden nicht gekennzeichnet | Vollständigkeits- und Qualitätsinformationen der Aggregation kontrollieren |
| Historische Minutenwerte fehlen nach Ablauf der Rohdaten-Retention | Aggregations- beziehungsweise Aktualisierungsregeln sind nicht korrekt mit der Löschung abgestimmt | Retention, Aktualisierungsfenster und Datenbankverhalten überprüfen |
| Nach einem Netzwerkausfall erscheinen Messwerte an falschen Zeitpunkten | Cloud-Empfangszeit statt ursprünglicher Messzeit verwendet | Zeitstempelherkunft und Nachlieferungsverfahren untersuchen |
| Nachgelieferte Daten verändern historische Statistiken nicht | Bereits abgeschlossene Fenster werden nicht erneut aggregiert | Late-Data-Handling und Aktualisierungsrichtlinien kontrollieren |
| Einige Datenpunkte liegen doppelt im Archiv | Wiederholte Übertragung ohne geeignete Datensatzidentifikation | Duplikaterkennung, Messstellen-ID und Zeitstempelverarbeitung prüfen |
| Langfristiger Trend zeigt auffällige Sprünge nach einem Sensorwechsel | Einheit, Skalierung oder Sensorkonfiguration wurde verändert | Metadaten, Umrechnung und historische Konfigurationsversionen überprüfen |
| Minutenwerte bleiben trotz Rohdatenlöschung auf unverändert hohem Speicherbedarf | Aggregate enthalten zusätzliche Kennwerte, Indizes oder unzureichende Kompression | Tatsächlichen Speicherbedarf und Datenbankstruktur analysieren |
| Nach Sommerzeitumstellung fehlen oder verdoppeln sich lokale Tageswerte | Zeitfenster wurden ohne eindeutige Zeitzonenregel definiert | UTC-Zeitbasis, lokale Kalenderfenster und Sommerzeitbehandlung prüfen |
| Ein Alarmereignis ist im Langzeittrend nicht mehr erkennbar | Diskrete Ereignisse wurden ausschließlich als Mittelwerte verarbeitet | Gesonderte Ereignisarchivierung und ereignisbezogene Rohdatenaufbewahrung prüfen |
| Historische Berichte zeigen nach Softwareänderung andere Werte | Aggregationsfunktion oder Qualitätsregeln wurden verändert | Berechnungsversion und gegebenenfalls notwendige historische Neuberechnung bewerten |
Die Tabelle beschreibt typische Ursachen und geeignete Prüfansätze.
Eine eindeutige Fehlerdiagnose muss anhand der tatsächlichen Datenarchitektur erfolgen.
Besonders wichtig ist die Unterscheidung zwischen einer fehlenden Messung, einem verworfenen Wert und einem nachträglich gelöschten Datensatz.
Diese drei Zustände können in einer unzureichend dokumentierten Datenbank ähnlich aussehen, besitzen aber unterschiedliche Ursachen.
Für eine belastbare Messdatenhistorie müssen daher Datenherkunft, Verarbeitung und Aufbewahrung gemeinsam nachvollziehbar sein.
22. Passende IIoT-Messtechnik und Integrationslösungen von ICS Schneider
22.1 ICS IIoT-Lösungen: Vom Sensor über das Edge-Gateway bis zum Langzeitarchiv
ICS Schneider unterstützt die herstellerübergreifende Einbindung industrieller Messgeräte in IIoT-, SCADA- und Cloud-Systeme.
Das Leistungsspektrum umfasst unter anderem Sensorik, Datenanbindung, Edge-Gateways, Datenmodellierung und die Integration in übergeordnete IT-/OT-Systeme.
Je nach Anwendung können beispielsweise RS-485/Modbus RTU, HART, IO-Link, OPC UA oder Ethernet als Schnittstellen auf der Feldebene verwendet werden.
Für die Kommunikation mit übergeordneten Systemen kommen unter anderem MQTT und HTTPS infrage.
Ein Edge-Gateway kann Messwerte erfassen, skalieren, mit Zeitstempeln versehen und entsprechend dem vorgesehenen Anlagenkonzept weiterverarbeiten.
Zusätzlich können lokale Alarmfunktionen und Datenpufferungen vorgesehen werden.
Die tatsächlichen Funktionen hängen von der ausgewählten Gateway-Hardware und Softwarearchitektur ab.
Eine mehrstufige Retention mit getrennten Sekunden-, Minuten- und Tageswerten ist daher als Funktion der Gesamtarchitektur zu spezifizieren und nicht automatisch jedem Gateway zuzuordnen.
ICS Schneider unterstützt bei der Auswahl der Komponenten, dem Datenmodell, der Schnittstellenintegration und der Dokumentation.
Weitere Informationen finden Sie unter IIoT-Lösungen.
22.2 IDCT531: Digitaler Drucksensor mit RS-485 und Modbus RTU
Der IDCT531 ist ein industrieller Drucksensor mit digitaler RS-485-Schnittstelle und Modbus-RTU-Kommunikation.
Der Sensor ist mit Nenndruckbereichen von 0 … 100 mbar bis 0 … 400 bar erhältlich.
Die dokumentierte Genauigkeit beträgt 0,25 % FSO.
Die Baureihe bietet ein gutes Temperaturverhalten und eine hohe Langzeitstabilität.
Durch die digitale Schnittstelle können die Messwerte von einer geeigneten Steuerung oder einem Edge-Gateway abgefragt werden.
Die tatsächlich mögliche Abfragefrequenz hängt von der Sensoraktualisierung, der verwendeten Kommunikation und der gesamten Buskonfiguration ab.
Der IDCT531 ist damit für entsprechende industrielle Drucküberwachungs- und IIoT-Anwendungen interessant.
Für eine langfristige Datenarchivierung muss zusätzlich festgelegt werden, wie die über Modbus erfassten Werte mit Zeitstempeln versehen und gespeichert werden.
Auch die Retention und Aggregation erfolgen nicht automatisch aufgrund der vorhandenen Modbus-Schnittstelle.
Diese Funktionen müssen durch das angeschlossene Erfassungs- beziehungsweise IT-System bereitgestellt werden.
22.3 WIKA PEW-1000: Drahtloser Drucksensor mit intelligenter Messsteuerung
Der WIKA PEW-1000 ist ein funkbasierter Drucksensor für allgemeine industrielle Anwendungen.
Das Gerät ermöglicht die Überwachung von Druckwerten an mobilen oder räumlich entfernten Messstellen.
Zur drahtlosen Kommunikation stehen je nach Geräteausführung LoRaWAN beziehungsweise mioty und Bluetooth zur Verfügung.
Ein wesentliches Merkmal ist die intelligente Mess- und Übertragungssteuerung.
Die Konfiguration ermöglicht unter anderem messwertabhängige Mess- und Sendeintervalle.
Der Sensor kann unter geeigneten Bedingungen häufiger messen, als er Werte über Funk überträgt.
Das kann den Energie- und Funkdatenbedarf reduzieren.
Für die Retention-Planung muss deshalb zwischen tatsächlich durchgeführten Messungen und den im Archiv verfügbaren übertragenen Messwerten unterschieden werden.
Eine interne hohe Messfrequenz bedeutet nicht automatisch, dass alle Einzelwerte in der zentralen Datenbank vorhanden sind.
Für anspruchsvolle Trend- und Ereignisanalysen müssen die Übertragungsstrategie und die tatsächlich verfügbaren Daten entsprechend ausgewählt werden.
Die spätere Verdichtung und langfristige Speicherung erfolgen in einer geeigneten übergeordneten Datenarchitektur.
Eine drahtlose Drucküberwachung ist damit besonders für dezentrale und nachträglich digitalisierte Messstellen interessant, sofern die zeitliche Auflösung zur tatsächlichen Messaufgabe passt.
22.4 WIKA NETRIS 3: LoRaWAN-Funkeinheit für industrielle Messgeräte
Die WIKA NETRIS 3 ist eine IIoT-fähige Funkeinheit zur drahtlosen Übertragung von Messwerten kompatibler WIKA-Messgeräte.
Die Kommunikation erfolgt über LoRaWAN.
Die Baureihe ist für entsprechende Anwendungen in explosionsgefährdeten Bereichen vorgesehen.
Das Gerät ermöglicht die Übertragung von Messwerten für eine zentrale Zustands- und Anlagenüberwachung.
Besonders bei räumlich verteilten Messstellen kann dadurch eine kabelgebundene Kommunikationsverbindung entfallen.
Die tatsächlichen Mess- und Übertragungsintervalle müssen jedoch zur Anwendung und den technischen Grenzen des Funknetzes passen.
Besonders bei batteriebetriebenen Funksystemen sind Energieverbrauch und Datenübertragungsmenge wichtige Auswahlkriterien.
Eine spätere minutengenaue oder tägliche Langzeitstatistik kann aus den tatsächlich übertragenen Messwerten berechnet werden.
Wenn nur wenige Einzelwerte übertragen werden, darf diese Statistik allerdings nicht als hochaufgelöste Messung interpretiert werden.
Die notwendige Auflösung, die gewünschte Retention und die Art der Ereignisübertragung müssen deshalb gemeinsam geplant werden.
22.5 IIoT-Druck-, Temperatur- und Füllstandüberwachung
ICS Schneider bietet IIoT-Integrationslösungen für unterschiedliche industrielle Messgrößen an.
Dazu gehören insbesondere Druck, Temperatur und Füllstand.
Bei der IIoT-Drucküberwachung stehen beispielsweise Pumpen, Druckluftsysteme und Prozessanlagen im Mittelpunkt.
Hier können hochaufgelöste Druckwerte für eine kurzfristige Störungsdiagnose sinnvoll sein, während langfristige Anlagenberichte häufig mit geeigneten verdichteten Daten arbeiten.
Die IIoT-Temperaturüberwachung ermöglicht die kontinuierliche beziehungsweise bedarfsgerechte Erfassung von Temperaturmesswerten.
Für Langzeittrends können je nach Anwendung geeignete Minuten-, Stunden- oder Tagesstatistiken verwendet werden.
Bei der IIoT-Füllstandüberwachung spielen unter anderem die langfristige Entwicklung des Behälterfüllstands und die Erkennung relevanter Grenzwerte eine Rolle.
Auch hier muss die zeitliche Auflösung zur tatsächlichen Prozessdynamik passen.
Ein langsam veränderlicher Tankfüllstand benötigt möglicherweise keine Speicherung im Sekundentakt.
Kurze Alarmereignisse oder schnell wechselnde Betriebszustände sollten dagegen entsprechend gesondert dokumentiert werden.
Die passende Retention-Strategie muss deshalb für jede Anwendung aus Messprinzip, Prozessverhalten und Informationsbedarf abgeleitet werden.
22.6 Auswahl einer geeigneten Datenarchitektur
Eine industrielle IIoT-Lösung besteht aus mehr als einem Sensor und einer Cloud-Verbindung.
Für die langfristig nutzbare Speicherung müssen Sensorik, Datenerfassung, Übertragung, Aggregation und Archivierung aufeinander abgestimmt sein.
Wichtige Auswahlkriterien sind die Anzahl der Messstellen, deren tatsächliche Messintervalle, die gewünschte zeitliche Auflösung und die erforderlichen Aufbewahrungsfristen.
Zusätzlich müssen mögliche Kommunikationsausfälle, lokale Pufferkapazitäten, Datenqualität und nachträgliche Änderungen berücksichtigt werden.
Auch die gewünschte Speicherumgebung ist relevant.
Je nach Anwendung kann eine lokale On-Premises-Architektur, eine Cloud-Plattform oder eine kombinierte Lösung sinnvoll sein.
Die in diesem Beitrag beschriebenen Möglichkeiten von InfluxDB und TimescaleDB dienen als technische Beispiele für Zeitreihendatenbanken. Sie sind nicht automatisch als eigenständige ICS-Produkte oder als Bestandteil jedes angebotenen IIoT-Systems zu verstehen.
ICS Schneider unterstützt bei der technischen Auswahl und Einbindung geeigneter Messtechnik sowie der Planung der entsprechenden Datenintegration.
Weitere Informationen finden Sie unter IIoT-Lösungen.
23. Fazit: Speicherdauer nach Informationswert statt nur nach Datenmenge planen
Industrielle Messdaten müssen nicht zwangsläufig über ihre gesamte Lebensdauer in derselben zeitlichen Auflösung gespeichert werden.
Eine abgestufte Retention kann den langfristigen Speicherbedarf erheblich reduzieren und gleichzeitig die Verfügbarkeit wichtiger Prozessinformationen verbessern.
Besonders sinnvoll kann die Kombination aus kurzfristig verfügbaren Rohdaten, mittelfristigen Minutenstatistiken und langfristigen Tageswerten sein.
Die passende Auflösung hängt jedoch von der jeweiligen Messaufgabe ab.
Für eine kurzfristige Fehlerdiagnose können hochaufgelöste Einzelmessungen erforderlich sein.
Für langfristige Energie- oder Anlagenberichte reichen dagegen häufig geeignete verdichtete Daten.
Entscheidend ist, welche Informationen bei der Verdichtung erhalten bleiben.
Ein gewöhnlicher Mittelwert kann kurze Druckspitzen oder andere relevante Prozessereignisse verdecken.
Deshalb sollten bei geeigneten Messgrößen auch Minima, Maxima und gegebenenfalls die zugehörigen Ereigniszeiten gespeichert werden.
Ebenso wichtig sind Informationen über Datenqualität und Vollständigkeit.
Ein scheinbar plausibler Tageswert ist nur eingeschränkt nutzbar, wenn nicht erkennbar ist, dass während eines großen Teils des Tages Messdaten fehlten.
Die Zeitbasis muss ebenfalls eindeutig sein.
Messzeitpunkt, Übertragungszeitpunkt und Aggregationsfenster erfüllen unterschiedliche Aufgaben und dürfen nicht unkontrolliert vermischt werden.
Besonders bei Edge-Pufferung und verspäteter Datenübertragung müssen die ursprünglichen Zeitstempel erhalten bleiben.
Auch Aggregation und automatische Datenlöschung müssen aufeinander abgestimmt sein.
Rohdaten dürfen nicht vorzeitig entfernt werden, wenn sie für noch ausstehende oder erforderliche erneute Berechnungen benötigt werden.
Für Alarme, Störungen und andere diskrete Ereignisse können zusätzlich eigene Archivierungsregeln notwendig sein.
Eine langfristig zuverlässige IIoT-Architektur benötigt daher nicht nur ausreichend Speicherplatz, sondern ein bewusst geplantes Datenmodell und einen nachvollziehbaren Datenlebenszyklus.
Messaufgabe festlegen → Erforderliche zeitliche Auflösung bestimmen → Rohdaten und Aggregate unterscheiden → Passende Mittelwerte und Extremwerte auswählen → Zeitfenster und Zeitstempel definieren → Datenqualität und Vollständigkeit dokumentieren → Retention je Datenebene festlegen → Edge-Pufferung und verspätete Daten berücksichtigen → Aggregation und Löschung abstimmen → Alarmereignisse separat archivieren → Historische Auswertungen überprüfen → Datenmodell und Betrieb dokumentieren
Der wichtigste praktische Grundsatz lautet damit: Nicht jeder Rohdatenwert muss dauerhaft gespeichert bleiben. Entscheidend ist, dass die verdichteten Daten auch Jahre später noch die für ihre jeweilige Aufgabe notwendigen Informationen enthalten – einschließlich Extremwerten, Zeitbezug, Datenqualität und nachvollziehbarer Berechnungsregeln.
24. Häufige Fragen zu Rohdaten, Datenverdichtung und Retention
24.1 Was bedeutet Retention bei industriellen Messdaten?
Retention bezeichnet die definierte Aufbewahrungsdauer von Daten. In einer IIoT-Datenbank kann beispielsweise festgelegt werden, dass Sekundenwerte nach 30 Tagen gelöscht werden, während Minuten- und Tagesstatistiken wesentlich länger gespeichert bleiben. Die konkrete Dauer hängt von der Anwendung und den geltenden Anforderungen ab.
24.2 Was ist der Unterschied zwischen Rohdaten und verdichteten Daten?
Rohdaten sind die ursprünglich im betrachteten Archiv erfassten Messwerte. Verdichtete Daten entstehen durch die Zusammenfassung mehrerer Messwerte innerhalb definierter Zeitfenster. Beispielsweise können aus Sekundenwerten Minutenmittelwerte sowie Minima und Maxima berechnet werden.
24.3 Warum sollten Sekundenwerte nicht immer dauerhaft gespeichert werden?
Bei vielen Messkanälen entstehen durch eine kontinuierliche Speicherung im Sekundentakt sehr große Datenmengen. Für langfristige Trends und Berichte werden häufig nicht sämtliche Einzelwerte benötigt. Eine abgestufte Retention kann deshalb den Speicherbedarf und den Aufwand für historische Abfragen reduzieren.
24.4 Wie lange sollten Rohdaten gespeichert werden?
Eine allgemeingültige Frist gibt es nicht. Die notwendige Dauer hängt von der Prozessdynamik, der gewünschten Fehlerdiagnose, dem Informationsbedarf und möglichen Dokumentationspflichten ab. Eine Aufbewahrung von beispielsweise 30 Tagen kann für bestimmte Anwendungen geeignet sein, während andere Prozesse wesentlich längere Rohdatenhistorien benötigen.
24.5 Was versteht man unter Downsampling?
Downsampling bezeichnet die Reduzierung der zeitlichen Datenauflösung. Dabei werden mehrere Messwerte zu geeigneten statistischen Kennwerten zusammengefasst. Beispielsweise kann aus 60 Sekundenwerten ein Minutenaggregat entstehen. Die ursprüngliche Information wird dadurch teilweise verdichtet und ist nicht mehr vollständig rekonstruierbar.
24.6 Reicht es aus, nur Minutenmittelwerte zu speichern?
Das hängt von der Messaufgabe ab. Für einfache Trends kann ein Minutenmittelwert ausreichend sein. Wenn kurze Druckspitzen, Temperaturüberschreitungen oder andere Extremwerte relevant sind, sollten zusätzlich geeignete Minima, Maxima und gegebenenfalls Ereignisdaten erhalten bleiben.
24.7 Wie lassen sich kurze Druckspitzen bei der Verdichtung erhalten?
Eine Möglichkeit besteht darin, neben dem Mittelwert auch das tatsächlich erfasste Maximum und dessen Zeitstempel zu speichern. Für besonders kurze Ereignisse muss außerdem die ursprüngliche Messrate ausreichend hoch sein. Eine nachträgliche Aggregation kann Druckspitzen, die bereits bei der Erfassung nicht gemessen wurden, nicht rekonstruieren.
24.8 Wie wird aus Minutenwerten ein korrekter Tagesmittelwert berechnet?
Bei arithmetischen Mittelwerten müssen die einzelnen Minutenwerte entsprechend der Anzahl ihrer gültigen Messwerte gewichtet werden, wenn diese unterschiedlich ist. Bei zeitgewichteten Mittelwerten sind dagegen die zugehörigen gültigen Zeitanteile beziehungsweise Integrale relevant. Ein einfacher Mittelwert aller Minutenmittelwerte ist nicht unter allen Bedingungen korrekt.
24.9 Warum sollte die Anzahl gültiger Messwerte gespeichert werden?
Die Anzahl gültiger Werte erlaubt eine Bewertung der Vollständigkeit und unterstützt die korrekte weitere Aggregation. Wenn in einer Minute statt 60 nur 45 gültige Sekundenwerte vorliegen, sollte dies erkennbar sein. Andernfalls kann eine unvollständige Messperiode fälschlich als vollständig interpretiert werden.
24.10 Was passiert mit fehlenden Messwerten bei der Aggregation?
Der Umgang mit Datenlücken muss ausdrücklich definiert werden. Fehlende Messwerte dürfen nicht ohne geeignete Regel durch null ersetzt werden. Je nach Anwendung können sie ausgeschlossen, als fehlend gekennzeichnet oder nach einem dokumentierten Verfahren interpoliert werden. Die Qualität des Aggregats muss dabei nachvollziehbar bleiben.
24.11 Ist ein arithmetischer Mittelwert immer für IIoT-Messdaten geeignet?
Nein. Bei gleichmäßig verteilten Messwerten kann er sinnvoll sein. Bei unregelmäßiger Datenerfassung kann dagegen ein zeitgewichteter Mittelwert die Prozessverhältnisse besser beschreiben. Die richtige Methode hängt vom Messprinzip, der Übertragung und der späteren Auswertung ab.
24.12 Wie werden Tageswerte bei einer Sommerzeitumstellung behandelt?
Das hängt davon ab, ob technische UTC-Zeitfenster oder lokale Kalendertage verwendet werden. Ein lokaler Kalendertag kann während der Sommerzeitumstellung 23 oder 25 Stunden enthalten. Die Fenstergrenzen und Zeitzonen müssen deshalb eindeutig definiert sein, damit keine Zeiträume doppelt oder falsch aggregiert werden.
24.13 Können nachgelieferte Messwerte bereits berechnete Aggregate verändern?
Ja. Wenn beispielsweise ein Edge-Gateway Messwerte während eines Netzwerkausfalls puffert und später überträgt, müssen die entsprechenden historischen Zeitfenster gegebenenfalls erneut berechnet werden. Dafür benötigt das System geeignete Aktualisierungsregeln und ausreichende Aufbewahrungsfristen.
24.14 Was passiert, wenn Rohdaten vor der Aggregation gelöscht werden?
Dann können die fehlenden historischen Aggregate möglicherweise nicht mehr vollständig berechnet werden. Auch spätere Korrekturen sind unter Umständen nicht mehr möglich. Aggregationsaufträge und Rohdaten-Retention müssen deshalb zeitlich aufeinander abgestimmt sein.
24.15 Sollten Alarme genauso lange gespeichert werden wie normale Messwerte?
Nicht unbedingt. Alarme, Störungen, Zustandswechsel und Quittierungen können einen anderen Informationswert besitzen als kontinuierliche Prozesswerte. Für solche Ereignisse können eigenständige Aufbewahrungsfristen und gegebenenfalls länger gespeicherte hochaufgelöste Datenabschnitte sinnvoll sein.
24.16 Welche Datenbanken unterstützen unterschiedliche Retention-Fristen?
Verschiedene industrielle Historians und Zeitreihendatenbanken unterstützen mehrstufige Speicherung. Beispiele sind InfluxDB und TimescaleDB mit entsprechenden Funktionen für zeitbasierte Aggregation und Aufbewahrung. Die tatsächliche Konfiguration und die verfügbaren Funktionen hängen von Produktversion und Architektur ab.
24.17 Welche passenden IIoT-Komponenten bietet ICS Schneider an?
ICS Schneider bietet Lösungen zur industriellen Erfassung und Übertragung von Druck-, Temperatur- und Füllstandmesswerten. Dazu gehören beispielsweise digitale Drucksensoren mit Modbus RTU wie der IDCT531 sowie drahtlose Messlösungen mit WIKA PEW-1000 oder NETRIS-Funkeinheiten. Zusätzlich unterstützt ICS die Integration in Edge-, SCADA- und Cloud-Systeme. Die konkrete Datenverdichtung und Retention müssen innerhalb der jeweiligen Gesamtarchitektur vorgesehen werden.
24.18 Welche Angaben benötigt ICS Schneider für die Planung einer Retention-Strategie?
Benötigt werden die Anzahl der Messstellen, die verwendeten Sensoren, tatsächlichen Messintervalle und die zu erfassenden physikalischen Größen. Besonders wichtig sind die erforderliche zeitliche Auflösung, relevante Druckspitzen oder andere Ereignisse und die gewünschten Aufbewahrungsfristen für Rohdaten, Minuten- und Tageswerte. Zusätzlich werden Informationen über vorhandene SPS- und Edge-Systeme, verwendete Schnittstellen, mögliche Kommunikationsunterbrechungen und die vorhandene IT-/OT-Infrastruktur benötigt. Für die Archivierung sind außerdem die gewünschten Aggregationsfunktionen, Anforderungen an Datenqualität und Vollständigkeit, Zeitstempelkonzept, Datenbanksystem, Speicherumgebung, Zugriffsrechte und gegebenenfalls gesetzliche oder vertragliche Dokumentationsanforderungen anzugeben. Auch Anforderungen an langfristige Berichte, spätere Neuberechnungen und die Archivierung von Alarmereignissen sollten frühzeitig festgelegt werden.